---
title: Búsqueda de patrones – Expresiones regulares
url: https://jarroba.com/busqueda-de-patrones-expresiones-regulares/
author: Ramón Invarato
date: 2015-02-08
modified: 2026-10-21
language: es
license: CC BY-NC-SA 3.0 (https://creativecommons.org/licenses/by-nc-sa/3.0/) — attribution: "Búsqueda de patrones – Expresiones regulares", Ramón Invarato, jarroba.com
categories: Lenguajes de Programación
tags: Busqueda de patrones, Coincidencia de patrones, Delimitadores, Diagramas de estados, Ejemplos, Expresiones Regulares, java, javascript, Patrones, Pattern matching, php, Reconocimiento de patrones, Regex, Regexp
---
# Búsqueda de patrones – Expresiones regulares
> Todo sobre expresiones regulares (Regexp) y búsqueda de patrones (Pattern matching) con ejemplos de Java, PHP y JavaScript para todas las posibilidades
La búsqueda o coincidencia de patrones (Pattern matching) está ideada para ahorrarte mucho tiempo y realizar procesos de una manera muy optimizada. Con los patrones podremos buscar algo, remplazar por todas las coincidencias por otra cosa, contar lo que se ha encontrado, ubicar la posición de lo que buscamos, entre otras ventajas. Lo mejor, prácticamente todos los lenguajes de programación lo soportan, funcionando en todos igual. Veremos ejemplos de expresiones regulares tanto en PHP, como en JavaScript, así como en Java.
Vamos a empezar poniendo la novena [definición de patrón de la RAE](http://lema.rae.es/drae/?val=patr%C3%B3n) (ni la primera, ni la segunda, ni tampoco la octava. La novena definición es la que nos interesa en el contexto en el que trabajamos):
> Modelo que sirve de muestra para sacar otra cosa igual.
Un patrón es un modelo, una plantilla, un molde, un diseño, que nos permite obtener varias cosas idénticas; es decir, es donde nos fijamos para copiar (como quien pinta un bodegón en un lienzo; donde el bodegón copiado con los objetos reales –el plátano, la jarra, el pan, las uvas- es el patrón). La “cosa” que indica la definición no tiene por qué ser solo un objeto físico, sino que puede ser un texto, una imagen, una idea, un modo de vivir, etc.
Y la otra palabra que utilizamos es “búsqueda”. Juntamos las dos y nos sale “Búsqueda de patrones” del inglés “Pattern matching” (“matching” viene del verbo “to match”, que significa algo que coincide; es decir “Coincidir con un patrón”, sinónimo a «Búsqueda de patrones»). Imagínate un cajón lleno de juguetes, y queremos buscar los juguetes coincidentes con un patrón, que puede ser un juguete con forma de barco; por lo que del cajón solo buscaremos los barcos: un barco pirata, un transatlántico, una piragua, etc. Esto es “Búsqueda de patrones”.
Nos hemos entretenido mucho, lo que nos interesa. Ahora vamos a enfocarnos en la programación, en mayoría suelen ser textos a analizar. Un ejemplo, nos va llegando la siguiente lista de textos (pueden ser los que queramos):
- ¡Hola Mundo!
- miCorreo@gmail.com
- La teoría de “Pattern Machine” dice…
- correoFalso@yahoo.es
- En un lugar de la Mancha, cuyo nombre no quiero acordarme…
- +34 91 123 456 789
- estoNOesUnCorreoNoTieneArroba.com
- RaMoN@jarroba.com
- Calle Alcalá 12345 Madrid, Madrid
Y nuestro patrón es “las direcciones de correos electrónicos”. Hay que buscar las direcciones de correos electrónicos en el listado anterior. Dicho esto, si vuelves al listado de textos, seguro que sacas todos los correos electrónicos que hay en unos segundos. Habrás descubierto que hay 3 direcciones de correos (“miCorreo@gmail.com”, “correoFalso@yahoo.es”, y “RaMoN@jarroba.com”); hay uno que parece una dirección de correo, pero no lo es, le falta la arroba (“estoNOesUnCorreoNoTieneArroba.com”). Tú mismo has aplicado “Búsqueda de patrones”.
Parafraseando a Neil deGrasse Tyson –astrónomo espectacular- en el documental “Cosmos” en doblaje español:
> *El talento humano para reconocer patrones es un arma de doble filo: **somos especialmente buenos encontrando patrones**, aun cuando realmente no están ahí.*
Aunque el párrafo en sí tiene mucho más significado dentro del guión del documental, he marcado en negrita lo que me interesa hacerte llegar “Somos especialmente buenos encontrando patrones”. Y quiero hacerte llegar lo fácil que es para nosotros utilizar esta herramienta. Se acabó eso de huir del mundo del “Pattern matching” (no sabes la cantidad de gente que evita su utilización alegando dificultad) , ya que es nuestro mundo, nuestro modo de aprendizaje, nuestro cerebro, nuestros pensamientos, lo que somos.
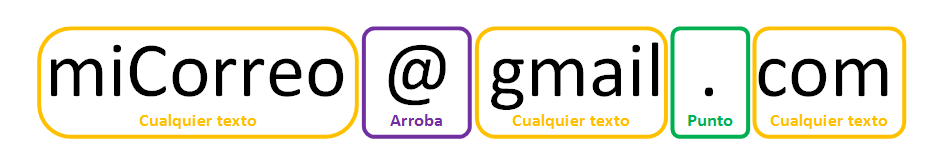
Tenemos que desmenuzar y decirle al ordenador que haga lo mismo que ha hecho nuestro cerebro. Le tenemos que decir que solo queremos las direcciones de correos electrónicos. Como tu cerebro es muy bueno encontrando patrones, seguro que te habrás dado cuenta de cuál es la estructura de un correo electrónico.
[](https://jarroba.com/wp-content/uploads/2015/02/Ejemplo-de-correo-reconocido-por-la-expresion-regular-www.jarroba.com_.png)
Habrás deducido que un correo electrónico está formado por un texto cualquiera, seguido de un símbolo de arroba, que le continúa un texto cualquiera, luego un punto, y termina con otro texto cualquiera.
**Nota para las urgencias**: Si tienes prisa puedes ir directamente a la parte de “Expresiones Regulares”. Explico los “Diagramas de estados” porque es una herramienta muy útil, es muy sencillo; y en el caso que nos ocupa, es muy útil para desgranar una expresión regular. También explico la diferencia de “Reconocimiento de patrones versus Búsqueda de patrones”, tampoco es necesario para entender cómo se utilizan las expresiones regulares.
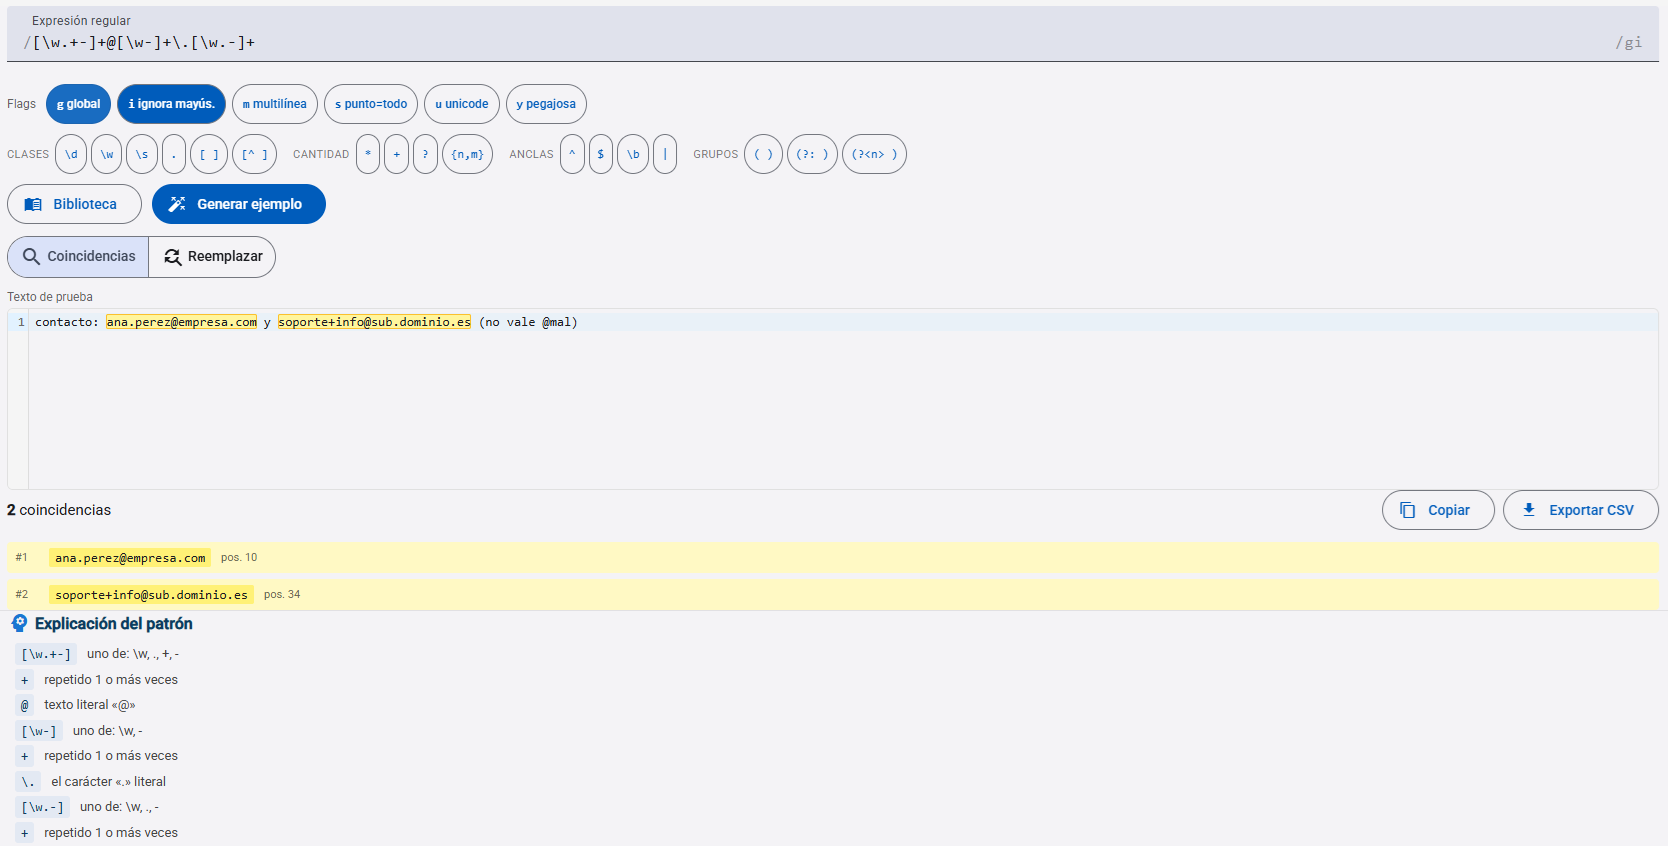
Herramienta
##### Regex Tester gratuito
[Pincha en este link para abrir un testeador de regex gratuito cortesía de Jarroba.com para que el aprendizaje sea práctico](https://jarroba.com/tools/es/regex).
[](https://jarroba.com/wp-content/uploads/2015/02/regex-tool-www.jarroba.com_.png)
## Diagrama de estados
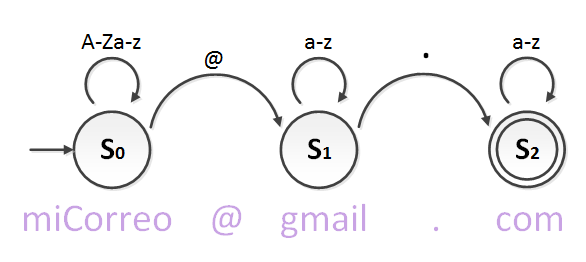
Es fácil crear el **diagrama de estados o autómata finito** del patrón de correos electrónicos. No es necesario en casos simples (cuando tengas un poco de práctica salen las expresiones regulares de cabeza), en casos complejos te aseguro que ayuda mucho.
El siguiente tiene muy buena pinta:
[](https://jarroba.com/wp-content/uploads/2015/02/Ejemplo-de-diagrama-de-estados-o-automata-finito-para-expresion-regular-www.jarroba.com_.png)
Puede que nunca hayas visto un diagrama de estados o autómata finito. En este pequeño párrafo te voy a explicar todo lo que hay que saber sobre diagramas de estados. La flecha de la izquierda indica el inicio. El círculo con la S simboliza el estado con su número (el número es para poner al estado un nombre único, un id; suelen ponerse en orden de lectura, aunque no es obligatorio, y cuando el diagrama de estados tiene varios caminos resulta imposible poner un orden). Las flechas indican qué es lo que se tiene que cumplir para pasar de un estado a otro, o permanecer en el mismo. El círculo con otro círculo dentro indica que ese estado será el final. Puede haber varios estados finales, así como varios inicios. El estado final es el objetivo, en caso de que lleguemos habremos reconocido lo que sea con éxito.
En el ejemplo, analizo la dirección de correo “miCorreo@gmail.com”. Empiezo por la flecha de entrada y llego al S0 por la primera letra “m”. Encima del estado S0 he puesto una flecha cíclica “A-Za-z” que indica que reconocerá cualquier letra una a una (“a-z” significa letras desde la “a” hasta la “z”, todo el abecedario), tanto en mayúsculas «A-Z» como en minúsculas «a-z». La flecha cíclica sobre el estado S0 siempre va a indicar que nos puede llegar entre cero letras e infinitas letras. Analizamos la letra “o” del final de la palabra “miCorreo” y nos encontramos con una “@”. El símbolo arroba «@» no pertenece al conjunto “A-Za-z”, pero sí que tiene otro camino. En cuanto llegamos a la arroba “@”, saltaremos al siguiente estado S1. En S1 reconoceremos solo letras minúsculas del conjunto “a-z”. Cuando lleguemos al punto “.” saltaremos al estado S2. En S2 igualmente reconoceremos cualquier letra minúscula. Como S2 está marcado como estado final, si se nos han acabado los caracteres a comprobar en este estado final, significa que nuestra dirección de correo electrónico ha sido validada. Para ver que el diagrama de estados cumple su función de validar direcciones de correos electrónicos, hay que analizar varios. Por ejemplo “RaMoN@jarroba.com” comprobaremos que también cumple. Si intentamos analizar “estoNOesUnCorreoNoTieneArroba.com”, nunca llegaríamos al estado final S2 -pues no hay arroba- por lo que no pasaría la validación.
Aunque bien mirado el diagrama de estados anterior, permite unas salidas no deseadas 🙁
Por ejemplo, permite el correo “@.”. ¡Sí, vacío!, solo la arroba y el punto. El anterior diagrama lo hice simple para entender la idea de un vistazo rápido, y ver cómo serían los ciclos entre cero y muchos; ahora vamos a complicarlo un poco para hacer ciclos entre uno y muchos. Para solventar este problemilla, lo que se puede hacer es forzar a que al menos haya una letra o más en cada parte (antes de la arroba, después de la arroba y después del punto).
[](https://jarroba.com/wp-content/uploads/2015/02/Ejemplo-de-diagrama-de-estados-o-automata-finito-completo-para-expresion-regular-www.jarroba.com_.png)
Ahora sí que sí 🙂
Nuestro diagrama de estados permite direcciones de correos del tipo “miCorreo@gmail.com” o “RaMoN@jarroba.com”. Y no permite direcciones de correos vacíos como el de “@.” o el de “@algo.”. Si te fijas en el diagrama de estados, obligamos en cada parte de la dirección del correo a que al menos haya una letra mínimo (por ejemplo, la flecha que pasa entre S0 y S1); luego todas las letras que se quieran (por ejemplo, el bucle en S1; hasta encontrar la arroba, momento para saltar al estado S2).
**Nota**: para amenizar la lectura he descrito ejemplos de direcciones de correos electrónicos simples. Existen otras direcciones de correos válidas en los estándares de Internet, como “correo_Numero8&dolar$@inglaterra.co.uk”. Es decir, podría tener números, guiones bajos, algunos caracteres más. E incluso podría tener varias extensiones en la parte final del dominio (normalmente el tipo de dominio de la actividad “.co”, seguido del tipo de dominio geográfico “.uk”). Si quieres conocer la sintaxis exacta de una dirección de correo electrónico, la tienes descrita en [Email address (Wikipedia)](http://en.wikipedia.org/wiki/Email_address), donde además tienes ejemplos de correos válidos e inválidos.
**Nota técnica de porqué ayudarte de diagramas de estados con expresiones regulares:**Dado que una expresión regular describe cadenas en lenguaje regular, las cuales entran dentro de los lenguajes formales (dicho rápidamente, un lenguaje formal es un texto que sigue unas normas; y en el caso que nos ocupa la norma la marca la expresión regular). Los autómatas finitos reconocen lenguajes regulares. Entonces cada expresión regular tiene asociado un autómata finito (tanto autómatas finitos deterministas o AFD, como autómatas finitos no deterministas o AFND).
## Reconocimiento de patrones versus Búsqueda de patrones
Lo que acabas de hacer -desmenuzar la dirección de correo electrónico para encontrar el patrón- se llama “Reconocimiento de patrones” (Pattern recognition).
No hay que confundir “Búsqueda de patrones” con “Reconocimiento de patrones”. Defino los dos rápidamente:
- **Reconocimiento de patrones (Pattern recognition):** extrae información de algo para obtener un patrón. El resultado es un patrón. En el ejemplo de la dirección de correo hemos obtenido el patrón de las direcciones de correos electrónicos a base de estudiarlo mentalmente. Que decir tiene que es una ciencia de computación que intenta llevar a un ordenador a encontrar patrones. Por ejemplo el reconocimiento de caras, donde el ordenador dado una cara de frente de una persona, tiene que saber sacar el patrón de esa cara (Reconocimiento de patrones); para posteriormente reconocerla en diferentes posiciones (Búsqueda de patrones), y sin equivocarse con las caras de otras personas.
- **Búsqueda de patrones (Pattern matching):** busca algo que coincida con un patrón. El resultado son todas las coincidencias con un patrón determinado. En el ejemplo, es encontrar todas las direcciones de correos electrónicos conociendo la estructura básica de un correo electrónico (que tiene arroba en medio y un punto); es decir, sabiendo su patrón.
Necesitamos reconocer un patrón (en el caso de la dirección de correo electrónico es muy sencillo), y luego utilizar este patrón para buscar aquellos textos que coincidan con ese patrón (en el ejemplo queremos encontrar cualquier dirección de correo electrónico, entre las infinitas posibilidades de combinación que pueda haber).
## Expresiones regulares
Para que nuestro ordenador sea capaz de reconocer direcciones de correo electrónico, lo tenemos que escribir en el formato que se llama “**expresión regular**” o “Regex” o «RegExp». Una expresión regular simplemente es una secuencia de caracteres. La expresión regular será nuestro patrón, que servirá para buscar algo en un determinado texto (en el caso del ejemplo, queremos encontrar las direcciones de correos electrónicos). En programación es muy útil utilizar expresiones regulares para buscar cadenas o sustituir textos que cumplan con cierta expresión regular (que cumpla con cierto patrón).
Las expresiones regulares siempre se escriben igual sea el lenguaje de programación que sea (por fortuna es un estándar). Al principio y al final siempre hay que poner delimitadores (en algunos lenguajes no es necesario, te lo explico un poco más abajo), que indiquen dónde empieza y dónde acaba la expresión regular; y en medio estará nuestro patrón:
```text
Delimitador Patrón Delimitador
```
**Sobre las tablas de símbolos que vienen a continuación:** te voy a poner las tablas de símbolos antes de mostrarte algún ejemplo. Podrías pensar «ya me tengo que aprender otro montón de símbolos». Te aseguro que no son tantos, muchos son el contrario del anterior, y la verdad es que entendidos unos pocos el resto vienen solos por pura necesidad lógica. Simplemente ojea las siguientes tablas rápidamente para tener una idea del conjunto, detente en los símbolos que tengas curiosidad, y pasa al siguiente punto; la necesidad de utilizar estas tablas viene sola, te terminas aprendiendo los símbolos con el uso. Antes te tengo que decir como interpretar las tablas. Cada tabla consta de cuatro columnas: la primera empezando por la izquierda y sin leyenda podríamos llamarla «Símbolo de expresión regular»; la segunda columna es la descripción de qué es lo que hace el símbolo; la tercera y cuarta van juntas, la tercera es un ejemplo de la expresión regular, y la última es el texto de ejemplo donde he marcado en negrita lo que reconoce la expresión regular. Decir que los ejemplos los he recorrido completos, buscando todas las coincidencias. Ya estás listo, ahora empecemos; aunque comenzaremos por los delimitadores, algo necesario para construir expresiones regulares.
#### **Delimitadores de la expresión regular**
Es necesario para indicar dónde empieza y dónde acaba un patrón. Es obligatorio en algunos lenguajes de programación o en algunas funciones (en los lenguajes donde no hay que poner delimitadores, traen delimitadores predefinidos puestos de manera automática). Pero donde es obligatorio se permite cualquier símbolo siempre que coincida el primero con el último, uno muy usado es“/” o “~”. Por ejemplo
```text
/patron/
```
Los únicos que no podremos usar son “\” y “ ” (espacio en blanco).
Otra opción, si nos gusta más, es utilizar pares de apertura y cierre como “()”, “{}”, “[]” y “<>”. Por ejemplo es válido:
```text
{patron}
```
Puede que nos sea necesario utilizar el mismo símbolo que ya utilizamos de delimitador dentro del patrón. Para ello le ponemos delante la barra “\”, que indica que ese carácter no es especial. Si prevemos que vamos a utilizar mucho un símbolo, lo mejor es usar otro delimitador, que para eso tenemos libertad (por ejemplo, si vas a analizar HTML, donde analizaríamos elementos como “texto en negrita”; sería incómodo utilizar los delimitadores de “/” o de “<>”).
```text
```
Al final, fuera de los delimitadores, pueden ir algunos modificadores de la expresión regular. Lo veremos en las tablas.
Indicar que los ejemplos de las siguientes tablas varío en el uso de los delimitadores para facilitar la lectura (utilizo «/» y «~»). Como es obvio, en los lenguajes que no necesiten delimitadores no habría que ponerlos.
#### **Caracteres especiales de búsqueda**
| | ***Descripción*** | ***Patrón de ejemplo*** | ***Ejemplo reconocido*** |
| --- | --- | --- | --- |
| ^ | Encuentra el elemento siguiente al **principio de línea** **Nota**: así usado no es una negación. No confundir con la negación de conjuntos “[^patron]”,que requiere los corchetes además del símbolo “^” | /^A/ | **A**sAdA |
| $ | Encuentra el elemento anterior al **final de línea** | /A$/ | AsAd**A** |
| * | Encuentra el elemento anterior **0 o más veces**. Es lo mismo que poner {0,} | /es*/ **Nota:**el “*” solo afecta a “s”, no a “e”. Si queremos que afecte a la “e” también, tendríamos que poner “/e*s*/”. Lo mismo le pasa al “+” y a “?” | Es **es** **e**l **ess** **e** os oss **esss** |
| + | Encuentra el elemento anterior **1 o más veces**. Es lo mismo que poner {1,} | /es+/ | Es **es** el **ess** e os oss **esss** |
| ? | Encuentra el elemento anterior **0 o 1 vez**. Es lo mismo que poner {0,1} | /es?/ | Es **es** **e**l **es**s **e** os oss **es**ss |
| . | Encuentra **cualquier carácter**, salvo el carácter de nueva línea. Es un comodín que sustituye a un carácter | /s.s/ | Es es el **ses** e o**s s**aa **sos** e**sss** |
| \ | El carácter puesto a continuación será**convertido en** **carácter especial o**, si ya es especial,**deja de ser especial** **Nota**: se puede hacer que deje de ser especial a la misma barra “\”. Bastará con poner “\\”, donde la primera barra es el carácter especial que quita a la segunda barra de ser especial. Y si queremos que haya dos barras seguidas que no sean especiales pondremos “\\\\”; cada barra que queramos que no sea especial tendrá que tener delante una barra que haga que la siguiente barra deje de ser especial | /midominio\.com/ | **midominio.com** **Nota**: el punto es un carácter especial que si lo queremos usar tiene que dejar de ser especial. Si ponemos “/midominio.com/”, sin la barra antes del punto, estamos diciendo que también es válido “midominioHcom”, pues el punto es un comodín |
#### **Paréntesis**
| | ***Descripción*** | ***Patrón de ejemplo*** | ***Ejemplo reconocido*** |
| --- | --- | --- | --- |
| [patron] | Encuentra **cualquier carácter de este conjunto** | /[eo]s/ | Es **es** el **es**s e **os** **os**s **es**ss e**os** o**es** uuus |
| [^patron] | Encuentra **cualquier carácter que no esté en este conjunto** | /[^eo]s/ | **Es** es el e**ss** e os o**ss** es**ss** eos oes uu**us** |
| (patron) | **Encuentra** lo que está entre paréntesis **y** **lo guarda**. **Nota**: Se guarda cada paréntesis en una variable numerada entre el 1 y el 99; siempre en incremento desde el 1 por cada par de paréntesis en el patrón. La variable 0 corresponde con el texto que ha encontrado el patrón. Por ejemplo: /(A)(B)\2\1/ es equivalente a /(A)(B)BA/. (Más ejemplos abajo) | /(guarda.)(guarda.)/ | **guardaAguardaB** 0 = “guardaAguardaB” 1 = “guardaA” 2 = “guardaB” **Nota**: Se reconoce toda la palabra y además la guarda en una variable |
| (?:patron) | **Encuentra** lo que está entre paréntesis, **pero no lo guarda**. | /(?:guarda.)(guarda.)/ | **guardaAguardaB** 0 = “guardaAguardaB” 1 = “guardaB” |
| {num} | Encuentra el elemento anterior **tantas veces como ponga en el número**. | /s{3}/ | Es es el ess e os oss e**sss** |
| {min,max} | Encuentra el elemento anterior **tantas veces entre un mínimo** (primer número) **y un máximo** (segundo número), ambos incluidos. Si en máximo no se pone nada, significa infinito | /s{2,3}/ | Es es el e**ss** e os o**ss** e**sss** |
#### **Caracteres**
| | ***Descripción*** | ***Patrón de ejemplo*** | ***Ejemplo reconocido*** |
| --- | --- | --- | --- |
| \b | Encuentra la **palabra exacta**, siempre ubicado en el límite de la palabra, normalmente un espacio. **Nota**: podemos encontrar un espacio en blanco en un conjunto poniendo “[\b]”, aunque también el propio espacio en blanco “[ ]”. | ~\bPala~~bra\b ~ **Nota**: está al principio o final de “Palabra” | **Pala**braPala**bra** |
| \B | Encuentra la **palabra exacta**, no tiene que estar ubicado en el límite de la palabra (Lo contrario a “\b”) | ~Pala\B~~\Bbra~ **Nota**: está en medio de “Palabra” | **Pala**braPala**bra** |
| \d | Encuentra un **dígito** del 0 al 9. Es lo mismo que poner [0-9] | ~\d~ | **5**del**12**de**1984** |
| \D | Encuentra un carácter que **no sea un dígito** del 0 al 9 (Lo contrario a “\d”). Es lo mismo que poner [^0-9] | ~\D~ | 5 **del** 12 **de** 1984 |
| \f | Encuentra un carácter de**nueva página** (form feed) | ~\f~ | Nueva Pagina **\f** fin |
| \n | Encuentra un carácter de**nueva línea** | ~\n~ | Nueva Linea **\n** fin |
| \t | Encuentra un carácter de**tabulación** | ~\t~ | Tabulacion Horizontal **\t** fin |
| \v | Encuentra un carácter de**tabulación vertical** **Nota:** Utilizado para el movimiento vertical de las impresoras | ~\v~ | Tabulacion Vertical **\v** fin |
| \r | Encuentra un carácter de**retorno de carro** **Nota**: Al pulsar la tecla “Enter”, antes de nueva línea | ~\r~ | Retorno de carro **\r** fin |
| \s | Encuentra un carácter de **espacio** (incluye espacio, tabular, nueva página, nueva línea, entre otros) | ~\s~ | Texto separado por espacios **Nota**: se reconocen los espacios en blanco |
| \S | Encuentra un carácter que **no sea** **espacio** (Lo contrario a “\s”) | ~\S~ | **Texto** **separado** **por** **espacios** **Nota:** se reconoce los que no son espacios en blanco |
| \w | Encuentra un carácter **alfanumérico** (incluye letras, números y barra baja). Es lo mismo que poner [A-Za-z0-9_]. | ~\w~ | **Ramon_1234**&**Ricardo_9876**@**jarroba.com** |
| \W | Encuentra un carácter que **no sea alfanumérico** (Lo contrario a “\w”). Es lo mismo que poner [^A-Za-z0-9_]. | ~\W~ | Ramon_1234**&**Ricardo_9876**@**jarroba**.**com |
| \n | Es la **variable guardada** por los paréntesis “(patron)”. “n” es un número positivo entre 1 y 99. | ~Numero capicua: (.).\1~ | **Numero capicua: 515** **Nota:** Hay un ejemplo completo sobre esto más abajo. |
| \0 | Encuentra un carácter **NUL**. El carácter null se representa como “\x00” | ~Es un nul: \0~ | **Es un nul: \x00** |
| \x{hhhh}\xhhhh | Encuentra un carácter **Unicode**. “hhhh” son cuatro dígitos hexadecimales. Algunos lenguajes de programación aceptan tanto “\x{hhhh}” o “\xhhhh”, o bien una sola **Nota**: Tienes todos los caracteres Unicode en (notar que en esta web aparecen escritos como “U+hhhh”, lo tenemos que transformar a “\x{hhhh}”): http://en.wikipedia.org/wiki/List_of_Unicode_characters | ~Unicode del caracter Arroba: \x{0040}~ | **Unicode del caracter Arroba: @** |
| \x{hh}\xhh | Encuentra un carácter **ASCII**. “hh” son dos dígitos hexadecimales. Algunos lenguajes de programación aceptan tanto “\x{hh}” o “\xhh”, o bien una sola **Nota**: Tienes todos los caracteres ASCII en (notar que en esta web aparecen escritos como dos dígitos hexadecimales, lo tenemos que transformar a “\x{hh}”): http://en.wikipedia.org/wiki/ASCII | ~ASCII del caracer Arroba: \x{40}~ | **ASCII del caracter Arroba: @** |
#### **Operadores lógicos**
| | ***Descripción*** | ***Patrón de ejemplo*** | ***Ejemplo reconocido*** |
| --- | --- | --- | --- |
| patron1\|patron2 | patron1 **o** patron2 | ~ojo\|a.a~ | **ojo asa** oro **aca** |
| patron1 (?=patron2) | Encuentra patron1 **solo si le sigue** patron2. patron2 no formará parte del resultado encontrado | ~ojo (?=cuidado)~ | **ojo** cuidado, ojo chispeante |
| patron1 (?!patron2) | Encuentra patron1 **solo si no le sigue** patron2. patron2 no formará parte del resultado encontrado | ~ojo (?!cuidado)~ | ojo cuidado, **ojo** chispeante |
#### **Modificadores**
Estos son modificadores de la expresión regular. Van siempre al final y fuera del delimitador. Algunos lenguajes de programación tienen estos modificadores en forma de función, que afecta al reconocimiento del texto por la expresión regular.
| | ***Descripción*** | ***Patrón de ejemplo*** | ***Ejemplo reconocido*** |
| --- | --- | --- | --- |
| g | Búsqueda global de **todas las coincidencias**.En PHP no existe, hay que utilizar el método “preg_match_all()” | /es/g | Es aqui, **es** el lugar donde **es** **Nota**: “Es” no se reconoce, por la letra mayúscula “E” |
| i | **No distinguir entre mayúsculas o minúsculas** | /es/i | **Es** aqui, **es** el lugar donde **es** |
| m | Encuentra los saltos de línea “\n”, para **separar cada línea de un texto**. Útil para utilizar con “^” o “$” | /^A/m | **A**rAdA\n**A**rAdA |
**Sobre las tablas:** Para crear estas tablas me he basado en los trabajos de [PCRE (PHP Manual)](http://php.net/manual/es/book.pcre.php) y de [RegExp – JavaScript (MDN)](https://developer.mozilla.org/es/docs/Web/JavaScript/Referencia/Objetos_globales/RegExp). Donde puedes encontrar más información al respecto, aunque he intentado hacer una recopilación con todo lo necesario. Todos los ejemplos han sido desarrollados y probados por mí.
## Crear una expresión regular
Ya tenemos toda la información necesaria, así que volvamos al último diagrama de estados. Vamos a crear nuestra expresión regular en base al diagrama de estados. Desgranémosla:
[](https://jarroba.com/wp-content/uploads/2015/02/Ejemplo-de-diagrama-de-estados-para-expresion-regular-explicado-www.jarroba.com_.png)
Apreciamos como el estado S0 y S1 nos indican que son letras mayúsculas y minúsculas, y que tienen que ser mínimo una letra o más letras. Revisando las tablas vemos que es lógico que sea “[A-Za-z]+” (El primer diagrama de estados, el que dije que permitía estados no deseados, indica ciclos entre cero y muchas letras, si miramos las tablas veremos que el asterisco nos apaña y valdría con poner “[A-Za-z]*”). Luego la arroba nos basta con poner “@”. Los estados S2 y S3 es lo mismo que antes, salvo porque no se permiten mayúsculas, por lo que “[a-z]+”. Luego llega un punto, pero cuidado con éste, si miramos las tablas aparece como carácter especial. Tenemos que hacer que deje de ser especial, es tan fácil como ponerle la barra “\” para que deje de ser especial. Y ya los estados S3 y S4 igual que antes “[a-z]+”.
Por tanto, la expresión regular que buscamos sería la siguiente (he utilizado la barra “/” como delimitador):
```text
/[A-Za-z]+@[a-z]+\.[a-z]+/
```
**¿Sabías que los analizadores sintácticos de los compiladores (de Java, Python, etc) usan expresiones regulares para saber si el código está bien escrito?** Ahora ya sabes quién tiene la culpa de cuando falta un “punto y coma” al final de una línea de código, que aparezca marcado en rojo en el IDE y entonces no compila el programa. Se debe a que la expresión regular que analiza el código tiene el “punto y coma” como obligatorio. Por tanto, sin “punto y coma” el código no pasa la validación. Sin embargo, otros lenguajes como JavaScript, sabrás que el “punto y coma” no es obligatorio; es razonable pensar que estarán usando el símbolo “?” detrás del “punto y coma” para que pueda aparecer cero o una vez, para que el “punto y coma” sea opcional. No me extiendo más, tienes más información sobre compiladores en [Compiler (Wikipedia)](http://en.wikipedia.org/wiki/Compiler)
Veamos unos ejemplos de uso de expresiones regulares tras responder a unas preguntas ¿Qué se puede hacer con las expresiones regulares? ¿Qué utilidad práctica tienen las expresiones regulares? ¿Para qué sirven las expresiones regulares? La respuesta la basaré en diferenciar el uso más típico de las expresiones regulares en programación con código funcional en Java, PHP y JavasCript:
- **Buscar** un patrón y decir si se ha encontrado o no
- **Remplazar** lo que ha encontrado un patrón por otra cosa
- **Separar** partes y guardarlas en variables
- **Contar**todas las coincidencias que encuentra un patrón
- **Posición**de cada coincidencia que haya encontrado el patrón
## Ejemplos de Búsqueda o Coincidencia
Queremos encontrar las direcciones de correos del listado anteriormente citado. La salida por consola en todos los casos va a ser:
*Correo reconocido: miCorreo@gmail.com*
*Correo reconocido: correoFalso@yahoo.es*
*Correo reconocido: RaMoN@jarroba.com*
El código dependerá del lenguaje. Unos ejemplos rápidos de algunos lenguajes son:
#### PHP
En PHP utilizaremos la función **preg_match()**, a la que le pasaremos el patrón y un texto del listado. Nos dirá si texto coincide con el patrón o no.
```php
Correo reconocido: ' . $texto;
}
}
```
#### JavaScript
Lo mismo pero con JavaScript. Para hacer la validación utilizaremos la función **test()**, cuyo objeto es el propio patrón que pondremos sin comillas (aquí la expresión regular actúa de objeto, no de String). A la función test() le pasaremos cada texto del listado. Nos devolverá “true” si coincide con la expresión regular, o “false” en caso contrario.
```javascript
var listaTextos = [
'¡Hola Mundo!',
'miCorreo@gmail.com',
'La teoría de “Pattern Machine” dice…',
'correoFalso@yahoo.es',
'En un lugar de la Mancha, cuyo nombre no quiero acordarme…',
'+34 91 123 456 789',
'estoNOesUnCorreoNoTieneArroba.com ',
'RaMoN@jarroba.com',
'Calle Alcalá 12345 Madrid, Madrid'
];
var patron = /[A-Za-z]+@[a-z]+\.[a-z]+/;
for (i = 0; i < listaTextos.length; i++) {
texto = listaTextos[i];
var esCoincidente = patron.test(texto);
if (esCoincidente) {
console.log('Correo reconocido: '+ texto);
}
}
```
#### Java
En Java es muy sencillo utilizar expresiones regulares, va todo por objetos. Primero tenemos que tener el patrón en un objeto “Pattern”, donde introduciremos la expresión regular sin delimitadores (incido en “sin delimitadores”) mediante el método compile(). Luego, solo tenemos que emparejar el texto con el patrón, nada más fácil que llamar al método matcher(), pasándole el texto que queramos comprobar; y nos devolverá un objeto de tipo “Matcher”. Para validar si coincide o no con la expresión regular utilizamos **find()** del objeto “Matcher”, donde se nos devolverá un “true” si coincide o un “false” si no (Una cosa muy cómoda es que si hay varias coincidencias con el patrón dentro del mismo texto, cada vez que llamemos a find() nos devolverá la siguiente coincidencia; un “while” nos descubriría todas).
**Nota**: si te fijas en la expresión regular, verás que el punto tiene doble barra “\\” delante. La primera barra es para Java (la barra “\” en los Strings de Java también convierte o quita de que sean caracteres especiales), no tiene nada que ver con la expresión regular; le dice a Java que la barra “\” de después es parte del String y que no la tiene que evaluar.
```java
package jarroba.com;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
public class expresionesRegulares {
public static void main(String[] args) {
String[] listaTextos = {
"¡Hola Mundo!",
"miCorreo@gmail.com",
"La teoría de 'Pattern Machine' dice…",
"correoFalso@yahoo.es",
"En un lugar de la Mancha, cuyo nombre no quiero acordarme…",
"+34 91 123 456 789",
"estoNOesUnCorreoNoTieneArroba.com",
"RaMoN@jarroba.com",
"Calle Alcalá 12345 Madrid, Madrid"
};
String regex = "[A-Za-z]+@[a-z]+\\.[a-z]+";
Pattern patron = Pattern.compile(regex);
for (String texto : listaTextos) {
Matcher emparejador = patron.matcher(texto);
boolean esCoincidente = emparejador.find();
if (esCoincidente) {
System.out.println("Correo reconocido: " + texto);
}
}
}
}
```
#### HTML
```xml
```
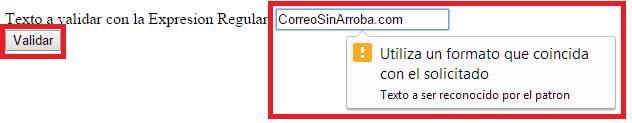
Si introducimos un dato que sea una dirección de correo electrónico, esta pasará la validación (se envía el formulario al hacer el “submit”). Si no pasa la validación mostrará un cuadro avisando de ello. Veríamos en el navegador la siguiente imagen (los estilos varían de navegador a otro; así se ve si se utiliza el navegador Chrome).
[](https://jarroba.com/wp-content/uploads/2015/02/Ejemplo-de-expresiones-regulares-en-HTML-validacion-de-formularios-HTML-www.jarroba.com_.png)
## Ejemplos de Sustitución o Remplazo
Vamos a hacer un ejemplo con paréntesis de guardado “(patron)”.
Sabemos que cada par de paréntesis “()” guarda el contenido coincidente entre el paréntesis de apertura y cierre una variable empezando desde el 1. Si tenemos 4 pares de paréntesis, tendremos información en las variables 1, 2, 3 y 4, donde 1 es el par de paréntesis de más a la izquierda y 4 el de más a la derecha de la expresión regular.
Esto es muy útil en muchos casos. Por ejemplo, si queremos reconocer un código de cualquiera HTML (o XML), como:
```xml
Texto en negrita
```
Podríamos diseñar una expresión regular como la siguiente (cambio el delimitador “/” por “~”, ya que el cierre del tag “” requiere el símbolo “/”, por simplificar la lectura):
```text
~<.+>.*~
```
Esta nos indica que buscaremos en los tags de apertura y cierre cualquier carácter 1 o más veces (pues los tags siempre han de tener algo, mínimo 1), y dentro del elemento buscaremos cualquier carácter 0 o más veces (podría ser vacío, por eso 0 o más). El problema está que las búsquedas requieren procesamiento. Podemos ahorrar cálculos si guardamos en variables. Sabemos que lo que nos encuentre el tag de apertura ha de ser igual al de cierre, por lo que podemos hacer lo siguiente:
```text
~<(.+)>.*~
```
De este modo buscamos la coincidencia y el paréntesis nos lo guarda en la variable “1”. Para llamar la variable dentro de la expresión regular, lo tenemos que tratar al “1” como símbolo especial y para ello se le pone “\” delante, por lo llamamos a la variable de la forma “\1”. Sin salirnos de la expresión regular sirve para cualquier lenguaje.
Ahora veamos otro uso muy interesante que es el de sustitución. Tenemos la siguiente fecha del tipo “d de F de Y” (donde “d” representa el día con dos dígitos, “F” el mes escrito, e “Y” el año con cuatro dígitos):
```text
31 de Enero de 2015
```
Queremos convertirlo al formato del tipo “d-F-Y” (es decir, que termine siendo “31-Enero-2015”).
Haríamos la siguiente expresión regular para obtener cada parte que nos interesa y guardar cada parte en una variable:
```text
/(\d+) de (\w+) de (\d+)/
```
El primer paréntesis desde la apertura “(” hasta su cierre “)” guardará el día “31” en la variable $1, el segundo el mes “Enero” en la variable $2, y el tercero el año “2015” en la variable $3. Utilizamos una función de remplazo que nos permita usar expresiones regulares y pueda sustituir la variables.
Vamos a poner algunos ejemplos completos, cuya salida de consola de todos es:
*Resultado despues de la sustitucion: 30-Enero-2015*
#### PHP
Es tan fácil como llamar a la función **preg_replace()**, donde le pasaremos la expresión regular, el texto donde tenemos que realizar la búsqueda, y el cómo queremos que nos sustituya a las variables; devolverá un String con las variables remplazadas tal y como queríamos.
```php
$texto = '30 de Enero de 2015';
$patron = '/(\d+) de (\w+) de (\d+)/';
$sustitucion = '$1-$2-$3';
$resultado = preg_replace($patron, $sustitucion, $texto);
echo '
Resultado despues de la sustitucion: "'.$resultado;
```
#### JavaScript
Simplemente llamando a la función **replace()** del texto, donde le pasaremos el patrón y el cómo queremos la sustitución de las variables; nos devolverá el resultado con las variables sustituidas.
```javascript
var patron = /(\d+) de (\w+) de (\d+)/;
var texto = '30 de Enero de 2015';
var sustitucion = '$1-$2-$3';
var resultado = texto.replace(patron, sustitucion);
console.log('Resultado despues de la sustitucion: '+ resultado);
```
#### Java
La búsqueda la explicamos en el anterior ejemplo de Java (recuerdo que la expresión regular ha de ir sin delimitadores). Para que nos busque el objeto “Matcher” tenemos que llamar a find(). Una vez encontrada la coincidencia, para realizar el remplazo podemos llamar al método **replaceAll()**, donde le pasaremos un String con el cómo queremos que remplace a las variables $1, $2 y $3; devolverá un String con las variables remplazadas.
```java
package jarroba.com;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
public class expresionesRegulares {
public static void main(String[] args) {
String regex = "(\\d+) de (\\w+) de (\\d+)";
Pattern patron = Pattern.compile(regex);
String texto = "30 de Enero de 2015";
Matcher emparejador = patron.matcher(texto);
emparejador.find();
String sustitucion = "$1-$2-$3";
String resultado = emparejador.replaceAll(sustitucion);
System.out.println("Resultado despues de la sustitucion: " + resultado);
}
}
```
## Ejemplos de Separación o extracción
Los anteriores ejemplos están muy bien. Pero qué pasa si lo que quiero es, de un texto coincidente con la expresión regular, quedarme con las partes que me interesen en variables para poder utilizarlas más adelante en el código de mi programa.
Por ejemplo, quiero quedarme con el día por un lado, el mes por otro, y el año por otro en variables; para poder utilizar estos valores en mi programa (creo que no hace falta que te diga que imagines los cientos de usos que tiene esto: saber si es día par o impar, sumar uno al día, comprobar si el mes cae en verano, etc; y eso solo con fechas, ¡Imagina con otros patrones y textos! Las posibilidades son infinitas). Supongamos que tenemos la misma fecha de antes:
```text
31 de Enero de 2015
```
Con la misma expresión regular quiero extraer cada parte a variables de mi lenguaje de programación para poder utilizar dichos valores:
```text
/(\d+) de (\w+) de (\d+)/
```
Vamos a poner algunos ejemplos completos, cuya salida por consola es la siguiente:
*Contenido en la variable $1: ’30’, en la variable $2: ‘Enero’, en la variable $3: ‘2015’*
#### PHP
Sencillamente usando **preg_match_all()**, donde le pasaremos la expresión regular, el texto, y un Array vacío (no hace falta inicializarlo) que nos llenará con las variables separadas. Luego podremos recorrer el Array, y así obtener los valores.
```bash
$texto = '30 de Enero de 2015';
$patron = '/(\d+) de (\w+) de (\d+)/';
preg_match_all($patron, $texto, $coincidencias);
$el1 = $coincidencias[1][0];
$el2 = $coincidencias[2][0];
$el3 = $coincidencias[3][0];
echo 'Contenido en la variable $1: \''.$el1.'\', en la variable $2: \''.$el2.'\', en la variable $3: \''.$el3.'\'';
```
El Array bidimensional devuelto “$coincidencias” con el contenido (la posición 0 es el texto reconocido por la expresión regular; el resto de posiciones son las variables cada una y en orden):
```text
array(4) {
[0]=> array(1) { [0]=> string(19) "30 de Enero de 2015" }
[1]=> array(1) { [0]=> string(2) "30" }
[2]=> array(1) { [0]=> string(5) "Enero" }
[3]=> array(1) { [0]=> string(4) "2015" }
}
```
#### JavaScript
Utilizando la función **match()**, cuyo objeto es el texto del que queremos extraer la información y pasándole la expresión regular como argumento. Obtendremos un array del cual obtener los valores.
```javascript
var patron = /(\d+) de (\w+) de (\d+)/;
var texto = '30 de Enero de 2015';
var coincidencias = texto.match(patron);
var el1 = coincidencias[1];
var el2 = coincidencias[2];
var el3 = coincidencias[3];
console.log('Contenido en la variable $1: \''+el1+'\', en la variable $2: \''+el2+'\', en la variable $3: \''+el3+'\'');
```
El array “coincidencias” que nos devuelve nos interesa de la posición 1 a la 3, siendo la posición 0 el texto reconocido por la expresión regular.
```text
0: "30 de Enero de 2015"
1: "30"
2: "Enero"
3: "2015"
```
#### Java
Como hemos hecho en los otros ejemplos en Java, obtendremos el objeto Matcher del objeto Pattern. Después de encontrar las coincidencias con find() del objeto Matcher. Y aquí simplemente llamaremos al método **group()** del objeto Matcher, donde le pasaremos un número entero que corresponderá con la posición de la variable que queremos obtener (a diferencia de PHP o JavaScript, aquí no nos devuelve un Array, sino que directamente el objeto Matcher nos devuelve las variables separadas al llamar a group() a la posición que queramos; si llamamos a la posición “0” con group(0), nos devolverá el texto reconocido por la expresión regular).
```java
package jarroba.com;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
public class expresionesRegulares {
public static void main(String[] args) {
String regex = "(\\d+) de (\\w+) de (\\d+)";
Pattern patron = Pattern.compile(regex);
String texto = "30 de Enero de 2015";
Matcher emparejador = patron.matcher(texto);
emparejador.find();
String el1 = emparejador.group(1);
String el2 = emparejador.group(2);
String el3 = emparejador.group(3);
System.out.println("Contenido en la variable $1: \'" + el1 + "\', en la variable $2: \'" + el2 + "\', en la variable $3: \'" + el3 + "\'");
}
}
```
## Ejemplos de Contar coincidencias y la posición donde fue cada una encontrada
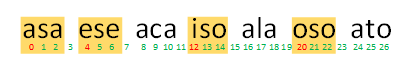
Aquí voy a aprovechar a hacer dos ejemplos muy útiles -ya que son bastante sencillos. Contaré el número de veces que aparece la coincidencia y mostraré la posición donde fue encontrada.
Por tanto, haré dos cosas con el texto:
```text
asa ese aca iso ala oso ato
```
Contaré todas las coincidencias con la siguiente expresión regular:
```bash
/.s./
```
Y diré en qué posición se han encontrado.
Veremos que hay 4 posibilidades, y donde está iniciando cada palabra.
[](https://jarroba.com/wp-content/uploads/2015/02/Expresion-regular-o-regex-para-encontrar-todas-las-coincidencias-www.jarroba.com_.png)
Por lo que la salida de consola para los siguientes lenguajes de programación va a ser:
*El numero de apariciones del patron .s. es 4*
*Palabra «asa» encontrada en la posicion 0*
*Palabra «ese» encontrada en la posicion 4*
*Palabra «iso» encontrada en la posicion 12*
*Palabra «oso» encontrada en la posicion 20*
#### PHP
Una de las particularidades de la función **preg_match_all()** es que devuelve el número de veces que ha coincidido el texto con la expresión regular. Tenemos las veces que aparece, ahora nos falta obtener la posición. Para hacerlo, es tan simple como añadir el flag “**PREG_OFFSET_CAPTURE**” a la función preg_match_all(), para pedir que nos devuelva además la posición dónde localiza a cada palabra.
```php
$texto = 'asa ese aca iso ala oso ato';
$patron = ' /.s./ ';
$numApariciones = preg_match_all($patron, $texto, $coincidencias, PREG_OFFSET_CAPTURE);
echo '
El número de apariciones del patron .s. es '.$numApariciones;
foreach ($coincidencias[0] as $palabraPosicion) {
echo '
Palabra "'.$palabraPosicion[0].'" encontrada en la posición '.$palabraPosicion[1];
}
```
El array “coincidencias” va a ser un array multidimensional, donde cada encuentro lo va a guardar en otro array de dos posiciones. La posición 0 del array será la palabra encontrada, y la posición 1 del array será la posición de dicha palabra en la frase. El resultante es:
```java
array(1) {
[0]=> array(4) {
[0]=> array(2) {
[0]=> string(3) "asa"
[1]=> int(0)
}
[1]=> array(2) {
[0]=> string(3) "ese"
[1]=> int(4)
}
[2]=> array(2) {
[0]=> string(3) "iso"
[1]=> int(12)
}
[3]=> array(2) {
[0]=> string(3) "oso"
[1]=> int(20)
}
}
}
```
#### JavaScript
En JavaScript tenemos que indicar que queremos encontrar todas las coincidencias con la expresión regular con el **modificador “g”** **al final de la expresión regular**, para que busque todas las coincidencias de toda la frase (si no lo ponemos solo encuentra “asa”; es decir, la primera que encuentra y para). Luego, para contar las coincidencias, usaremos la función **match()** que nos devuelve un array con todos los encuentros, por lo que nos bastará con contar el array para saber el total. Para conseguir la posición de cada coincidencia utilizaremos el método **exec()**, que nos irá encontrando de una en una todas las coincidencias cada vez que lo llamemos dentro de un bucle; luego la posición es el atributo “index” que devuelve esta función.
```javascript
var texto = 'asa ese aca iso ala oso ato';
var patron = /.s./g;
var coincidencias = texto.match(patron);
var numApariciones = coincidencias.length;
console.log("El numero de apariciones del patron .s. es " + numApariciones);
while ((coincidencia = patron.exec(texto)) != null) {
console.log('Palabra "'+coincidencia+'" encontrada en la posicion '+coincidencia.index);
}
```
El array “coincidencias” tiene lo siguiente:
```text
0: "asa"
1: "ese"
2: "iso"
3: "oso"
length: 4
```
Y un ejemplo de lo que contiene el array “coincidencia”
```text
0: "asa"
index: 0
input: "asa ese aca iso ala oso ato"
```
#### Java
Similar a los otros ejemplos en Java de más arriba, simplemente utilizamos el objeto **Matcher** para ir encontrando cada coincidencia con el método **find()** dentro de un bucle while. Luego, simplemente el objeto Matcher ubicará internamente su cursor en cada encuentro, por lo que si llamamos a la función **group()** nos devolverá la palabra en ese momento, y para saber en qué posición se encuentra llamaremos al método **start()** (y si queremos saber dónde acaba la palabra podemos llamar a end() ). Para contar las apariciones no tenemos más opción que ir contándolas una a una. Para que coincida la salida de consola con la del ejemplo, he utilizado StringBuilder, que lo único que hace es concatenar los Strings con las funciones append() (es igual que hacer “string unido a”+“otro string”; pero con más opciones, como la posibilidad de insertar al principio con insert() ).
```java
package jarroba.com;
import java.util.regex.Matcher;
import java.util.regex.Pattern;
public class expresionesRegulares {
public static void main(String[] args) {
String regex = ".s.";
Pattern patron = Pattern.compile(regex);
String texto = "asa ese aca iso ala oso ato";
Matcher emparejador = patron.matcher(texto);
StringBuilder devolver = new StringBuilder();
int numApariciones = 0;
while (emparejador.find()) {
devolver.append("\nPalabra \"" + emparejador.group() + "\" encontrada en la posicion " + emparejador.start());
numApariciones++;
}
devolver.insert(0, "El numero de apariciones del patron .s. es " + numApariciones);
System.out.append(devolver.toString());
}
}
```
## Varios ejemplos de expresiones regulares
Para solventar dudas en esta sección voy a ir poniendo varios ejemplos de expresiones regulares. Puedes utilizarlos como ejercicios para coger un poco de soltura. Casi todo se basa en pensar un poco, hacer el diagrama de estados (si tienes soltura los harás de cabeza), y mirar las tablas de símbolos de las expresiones regulares antes citadas.
#### **Expresión regular de teléfono fijo en España**
para otros países cambian las normas, pero son parecidos, ya tienes ejercicio 😉
- El prefijo del país España es siempre “+34”
- Luego va el prefijo de la comunidad autónoma, son entre 2 y 3 cifras que comienzan siempre por “9”
- Y luego va el número, que son siempre 7 cifras numéricas
- Cada uno de los grupos anteriores está separado por un espacio en blanco
Un ejemplo de teléfono válido en España es: +34 91 1234567
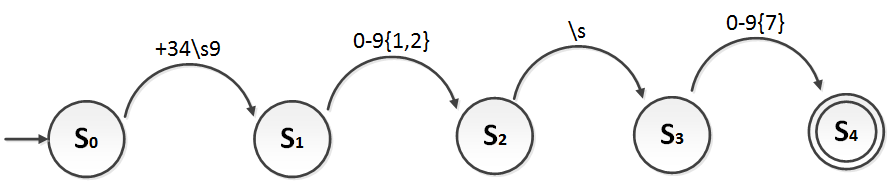
Su diagrama de estados podría ser (utilizando la simbología de expresiones regulares se puede simplificar lo suficiente como para entender los pasos de un vistazo):
[](https://jarroba.com/wp-content/uploads/2015/02/Ejemplo-de-telefono-con-expresion-regular-www.jarroba.com_.png)
Indicar que a este diagrama de estados le he añadido un nuevo símbolo entre llaves “{}”. Indica lo mismo que en las expresiones regulares, el símbolo “{1,2}” indica que puede haber desde 1 hasta 2 caracteres (en este caso caracteres del 0 al 9), y “{7}” indica que tienen que ser justos 7 caracteres (en este caso del 0 al 9).
También recuerdo que “\s” simplemente significa que se espera un espacio en blanco “ ” (“\s” está también en la tabla de expresiones regulares). En la expresión regular da igual poner “\s” o “ ”.
La expresión regular resultante:
```text
/\+34\s9[0-9]{1,2}\s[0-9]{7}/
```
O lo que es lo mismo:
```text
/\+34 9[0-9]{1,2} [0-9]{7}/
```
## Probar online
Puedes practicar y probar online las expresiones regulares desde:
- [http://www.regexr.com/](http://www.regexr.com/)
- [regex101: Online Regex Tester, Builder, Converter & Debugger](https://regex101.com/)
## Bibliografía
- Experiencia propia (si tienes dudas pregunta)
- [Pattern matching (Wikipedia)](http://en.wikipedia.org/wiki/Pattern_matching)
- [Pattern recognition (Wikipedia)](http://en.wikipedia.org/wiki/Pattern_recognition)
- [Regular expression (Wikipedia)](http://en.wikipedia.org/wiki/Regular_expression)
- [Sintaxis de expresiones regulares PCRE (PHP Manual)](http://php.net/manual/es/reference.pcre.pattern.syntax.php)
- [PCRE (PHP Manual)](http://php.net/manual/es/book.pcre.php)
- [RegExp – JavaScript (MDN)](https://developer.mozilla.org/es/docs/Web/JavaScript/Referencia/Objetos_globales/RegExp)
- [Lesson: Regular Expressions (The Java Tutorials, Essential Java Classes)](http://docs.oracle.com/javase/tutorial/essential/regex/index.html)