---
title: Scraping en Java (JSoup), con ejemplos
url: https://jarroba.com/scraping-java-jsoup-ejemplos/
author: Richard [Admin Jarroba]
date: 2015-05-12
modified: 2026-10-21
language: es
license: CC BY-NC-SA 3.0 (https://creativecommons.org/licenses/by-nc-sa/3.0/) — attribution: "Scraping en Java (JSoup), con ejemplos", Richard [Admin Jarroba], jarroba.com
categories: Inteligencia Artificial, Lenguajes de Programación
tags: java, jsoup, scraping
repository: https://github.com/jarroba/Scraping_jarroba
---
# Scraping en Java (JSoup), con ejemplos
> El Web Scraping son un conjunto de técnicas que se utilizan para obtener de forma automática el contenido que hay en páginas web a través de su código HTML.
El proyecto de este post los puedes descargar pulsando [AQUI](https://github.com/jarroba/Scraping_jarroba).
El ***Web Scraping (o Scraping)*** son un conjunto de técnicas que se utilizan para obtener de forma automática el contenido que hay en páginas web a través de su código HTML. El uso de estas técnicas tienen como finalidad recopilar grandes cantidades de datos de diferentes páginas web cuyo uso posterior puede ser muy variado: homogeneización de datos, tratamiento de contenido para la extracción de conocimiento, complementar datos en una web, etc. Decir por último en esta introducción que las técnicas de Scraping se pueden enmarcar dentro de los campos de la Inteligencia Artificial y del Big Data en la primera fase de recolección de datos para su posterior almacenamiento, tratamiento y visualización.
En este tutorial vamos a «scrapear» (o a obtener los datos) de los artículos y tutoriales de esta página web, utilizando la librería «[JSoup](https://jsoup.org/apidocs/)» (para Java) que es una librería que nos facilita muchísimo la labor de scrapeo. La finalidad de este tutorial no es hacer un tutorial para expertos, sino hacer una introducción de como hacer las conexiones HTTP y como tratar y extraer el contenido que nos interesa de los HTMLs que obtenemos con la libreria JSoup. Para este tutorial es necesario que se tengan conocimientos mínimos de HTML y CSS (no hace falta ser un experto) ya que a la hora de scrapear tenemos que tener conocimiento de las etiquetas de HTML como pueden ser head, body, h1, h2, …, h6, p, div, span, table, etc. y de los estilos CSS que se pueden aplicar a estas etiquetas con id y class.
Dadas las directrices y los conocimientos mínimos necesarios para este tutorial vamos a proceder a explicar como scrapear y obtener los datos de las entradas de jarroba.com. En primer lugar vamos a utilizar la libreria JSoup, por tanto nos la debemos importar, bien sea con el ".jar" o a través de Maven. En este caso nos hemos creado un proyecto [Maven](https://jarroba.com/maven-en-eclipse/) e importamos el JSoup añadiendo a nuestro fichero pom.xml lo siguiente:
```java
org.jsoup
jsoup
1.8.1
```
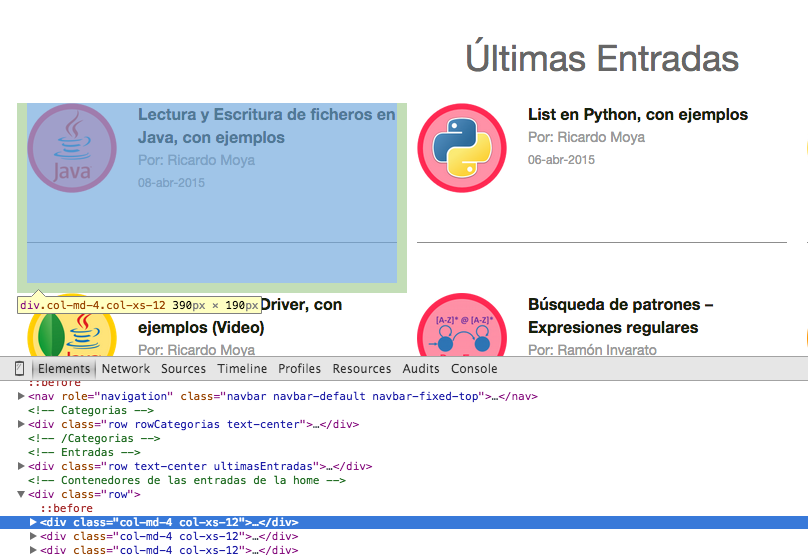
En segundo lugar, se ha de ***estudiar la estructura del HTML de la web*** para ver de qué forma podemos extraer su contenido. En este caso en el que queremos extraer la información de cada entrada de este web (título, autor y fecha), podemos ver como todas las entradas están entre etiquetas ‘div’ con la clase CSS ‘col-md-4 col-xs-12’; es decir (tal y como vemos en la siguiente imagen), debemos de obtener el contenido que hay entre «*********contenido******
***"
[](https://jarroba.com/wp-content/uploads/2015/04/scraping_jarroba_1.png)
Como podemos ver, puede resultar relativamente sencillo crearse una expresión regular y obtener todas las apareciones que hay entre las etiquetas 'div' con la clase CSS mencionada anteriormente (por cierto son clases de CSS Bootstrap), pero la libreria ***JSoup ya nos aporta los métodos necesarios*** (y muy bien optimizados ya que el Patter y Matcher son procesos muy pesados y lentos) para obtener el contenido que hay entre las etiquetas HTML.
Dentro de esas etiquetas, tenemos que seguir extrayendo los datos del título, autor y fecha. Si vemos más en detalle su HTML, vemos lo siguiente:
[](https://jarroba.com/wp-content/uploads/2015/04/scraping_html_jarroba.png)
Por tanto con esto ya hemos hecho un estudio del HTML y ya sabemos a partir de que etiquetas tenemos que scrapear los datos, por tanto vamos a pasar ahora a explicar como hacer el scrapeo con la libreria JSoup.
En primer lugar tenemos que hacer ***una petición HTTP*** a la página web para obtener su HTML. Previamente, seria recomendable (aunque no necesario, pero ya de paso lo explico), saber el estado o el "status code" de la petición a esa web. Para ello JSoup tiene los métodos necesarios para darnos el "status code" y a continuación podeis ver un método que dado una url nos devuelve su "status code":
```java
/**
* Con esta método compruebo el Status code de la respuesta que recibo al hacer la petición
* EJM:
* 200 OK 300 Multiple Choices
* 301 Moved Permanently 305 Use Proxy
* 400 Bad Request 403 Forbidden
* 404 Not Found 500 Internal Server Error
* 502 Bad Gateway 503 Service Unavailable
* @param url
* @return Status Code
*/
public static int getStatusConnectionCode(String url) {
Response response = null;
try {
response = Jsoup.connect(url).userAgent("Mozilla/5.0").timeout(100000).ignoreHttpErrors(true).execute();
} catch (IOException ex) {
System.out.println("Excepción al obtener el Status Code: " + ex.getMessage());
}
return response.statusCode();
}
```
JSoup nos proporciona los métodos necesarios para obtener el HTML de una url; o dicho de otra manera, hace la petición HTTP dada una url. En el siguiente fragmento de código vemos como dada una url nos devuelve un objeto de la clase «***Document***" con el contenido del HTML:
```java
/**
* Con este método devuelvo un objeto de la clase Document con el contenido del
* HTML de la web que me permitirá parsearlo con los métodos de la librelia JSoup
* @param url
* @return Documento con el HTML
*/
public static Document getHtmlDocument(String url) {
Document doc = null;
try {
doc = Jsoup.connect(url).userAgent("Mozilla/5.0").timeout(100000).get();
} catch (IOException ex) {
System.out.println("Excepción al obtener el HTML de la página" + ex.getMessage());
}
return doc;
}
```
La clase "Document" es una clase que guarda el HTML obtenido de una petición y que posteriormente nos servirá para obtener el contenido entre etiquetas HTML y clases CSS.
Por último vamos a pasar a mostrar el código de scrapeo de las entradas de la página principal de Jarroba.com y posteriormente explicaremos sus detalles:
```java
public class Scraping {
public static final String url = "https://jarroba.com/";
public static void main (String args[]) {
// Compruebo si me da un 200 al hacer la petición
if (getStatusConnectionCode(url) == 200) {
// Obtengo el HTML de la web en un objeto Document
Document document = getHtmlDocument(url);
// Busco todas las entradas que estan dentro de:
Elements entradas = document.select("div.col-md-4.col-xs-12").not("div.col-md-offset-2.col-md-4.col-xs-12");
System.out.println("Número de entradas en la página inicial de Jarroba: "+entradas.size()+"\n");
// Paseo cada una de las entradas
for (Element elem : entradas) {
String titulo = elem.getElementsByClass("tituloPost").text();
String autor = elem.getElementsByClass("autor").toString();
String fecha = elem.getElementsByClass("fecha").text();
System.out.println(titulo+"\n"+autor+"\n"+fecha+"\n\n");
// Con el método "text()" obtengo el contenido que hay dentro de las etiquetas HTML
// Con el método "toString()" obtengo todo el HTML con etiquetas incluidas
}
}else
System.out.println("El Status Code no es OK es: "+getStatusConnectionCode(url));
}
}
```
En primer lugar ***definimos la url***para obtener el HTML de la misma. En segundo lugar ***comprobamos que el "status code" es igual a 200*** y si es así obtenemos en un objeto de la clase "***Document***" el HTML de la web. Con ese objeto de la clase Document, vamos a poder obtener con los métodos pertinentes de JSoup, los elementos de la web. En este caso vamos a obtener todas las entradas que las guardaremos en un objeto de la clase "***Elements***" que corresponda a una serie de etiquetas y estilos CSS. En este caso guardaremos todos los fragmentos HTML que correspondan a cada entrada (ver primer imagen de la entrada):
```java
// Obtengo el HTML de la web en un objeto Document
Document document = getHtmlDocument(url);
// Busco todas las historias de meneame que estan dentro de:
Elements entradas = document.select("div.col-md-4.col-xs-12").not("div.col-md-offset-2.col-md-4.col-xs-12");
```
En este caso utilizamos el método "***select***» que lo que hace es coger todos los fragmentos del HTML que correspondan a una etiqueta div, seguido de las clases ‘col-md-4’ y ‘col-xs-12’. Dado que en la web hay otro fragmento de código que contiene la clase CSS ‘col-md-4’, seguido de otras clases y no corresponden a ninguna entra y por tanto no lo queremos seleccionar, le decimos con el método «***not***«, que no nos seleccione ese fragmento de HTML. Ahora ya tenemos en una lista (entradas), todas las entradas en HTML. Ahora debemos de recorrer esa lista y obtener de esos fragmentos de código los datos del título, autor y fecha. De la misma forma esa información está dentro de etiquetas HTML y clases CSS que debemos de tratar (como se muestra en la segunda imagen de la entrada). JSoup nos da los métodos para obtener el contenido pasandole el nombre de la clase CSS. Esto se hace de la siguiente forma:
```java
// Paseo cada una de las entradas
for (Element elem : entradas) {
String titulo = elem.getElementsByClass("tituloPost").text();
String autor = elem.getElementsByClass("autor").toString();
String fecha = elem.getElementsByClass("fecha").text();
System.out.println(titulo+"\n"+autor+"\n"+fecha+"\n\n");
// Con el método "text()" obtengo el contenido que hay dentro de las etiquetas HTML
// Con el método "toString()" obtengo todo el HTML con etiquetas incluidas
}
```
Como vemos a los métodos "***getElementsByClass***» se les pasa el nombre de la clase CSS y te obtiene el contenido que hay entre esas etiquetas. Por último señalar lo que dejo en el comentario del fragmento de código anterior y es que no es lo mismo utilizar el método «toString()» y el método «***text()***", que este último si que es propio de la libreria JSoup y te da el contenido que hay entre las etiquetas HTML, mientras que el método "toString()" te da el contenido más el HTML. Veamos el resultado de la ejecución del programa para que veais el resultado:
```text
Número de entradas en la página inicial de Jarroba: 9
Diccionario en python, con ejemplos
Por: Ricardo Moya
05-may-2015
DataSet de resultados de partidos de fútbol para su predicción (Machine Learning)
Por: Ricardo Moya
26-abr-2015
Intalar Ubuntu en una máquina virtual con VirtualBox (Video)
Por: Ricardo Moya
15-abr-2015
............
............
```
Esta libreria JSoup, es una libreria muy potente para hacer scraping. En esta entrada hemos visto como hacer una conexión HTTP y obtener el contenido HTML para almacenarlos en un objeto de la clase ***Dcoument*** para posteriormente sacar elementos o fragmentos de código HTML (clase ***Element*** o ***Elements*** si son varios) como si de un parseo con expresiones regulares se tratase pero sin meterse en el "engorro" de trabajar con expresiones regulares. JSoup también tiene métodos para sacar el contenido de etiquetas como los h1, h2, …, p, img, etc. que en este caso no hemos visto en el ejemplo pero que si revisais su javadoc veréis los métodos que permiten hacer esas acciones.
Para terminar dejo el programa que permite obtener todas las entradas de Jarroba.com (título, autor y fecha) y no solo los de la página principal como en el ejemplo mostrado:
```java
package com.jarroba.scraping.Scraping_jarroba_java;
import java.io.IOException;
import org.jsoup.Connection.Response;
import org.jsoup.Jsoup;
import org.jsoup.nodes.Document;
import org.jsoup.nodes.Element;
import org.jsoup.select.Elements;
public class Scraping_allPost {
public static final String url = "https://jarroba.com/page/%s/";
public static final int maxPages = 20;
public static void main (String args[]) {
for (int i=1; i