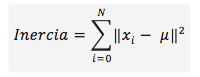

Análisis de resultados de fútbol con Power BI
El Business Intelligence no es más que un proceso que consiste en transformar los datos en información y la información en conocimiento para la toma de decisiones empresariales.
Código
Dentro de los artículos hay más ajustes: ancho, letra, posición de la serie y del código.
Se recuerda en este navegador.
El Business Intelligence no es más que un proceso que consiste en transformar los datos en información y la información en conocimiento para la toma de decisiones empresariales.
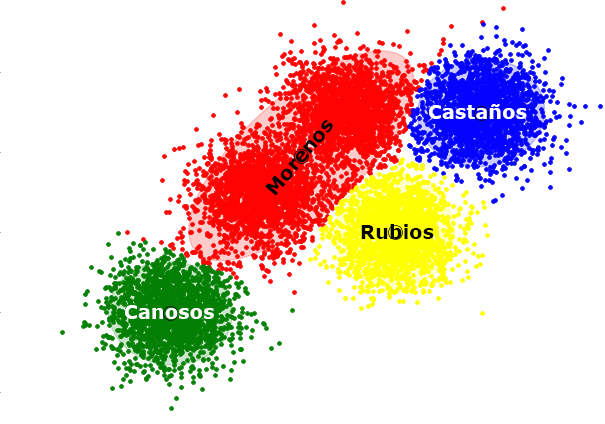
Uno de los problemas que nos encontramos a la hora de aplicar alguno de los métodos de Clustering (K-means o EM) es la elección del número de Clusters.
El Expectation-maximization es un método estadístico de Clustering similar al K-means, pero con un enfoque probabilístico. Este método asume que todos los objetos han sido generados a partir de ‘k’ distribuciones de probabilidad
El K-means es un método de Clustering que separa ‘K’ grupos de objetos, minimizando un concepto conocido como inercia, que es la suma de las distancias al cuadrado de cada objeto del Cluster a un punto ‘μ’ conocido como Centroide.
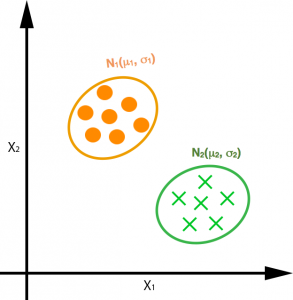
El Clustering es una tarea que consiste en agrupar un conjunto de objetos (no etiquetados) en subconjuntos de objetos llamados Clusters.
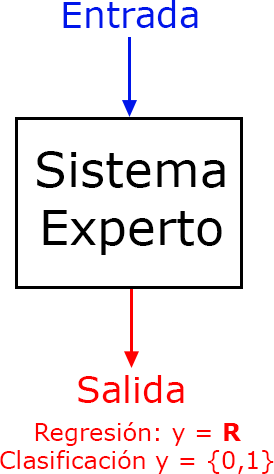
El Machine Learning (ML) o Aprendizaje Autónomo es una rama de la Inteligencia Artificial (IA) que tiene como objetivo crear sistemas capaces de aprender por ellos mismos a partir de un conjunto de datos (data set), sin ser programados de forma explícita.
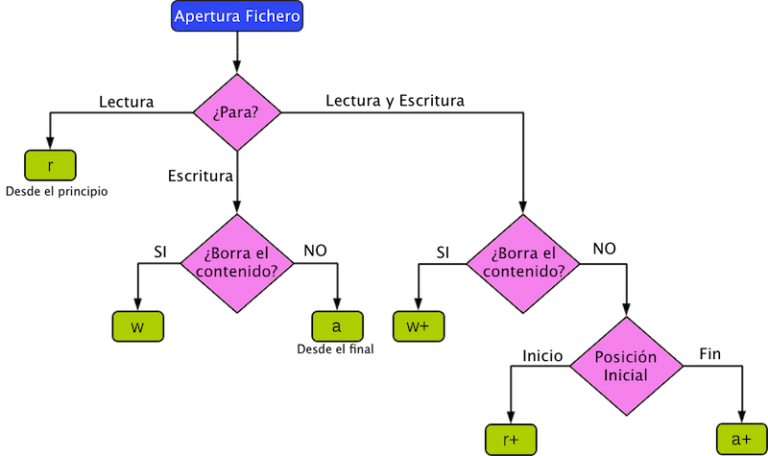
En este tutorial vamos a ver como leer y escribir ficheros en Python, dado que es una de las cosas que suele ser muy útil y utilizada a la hora de programar.

El patrón de diseño "Singleton", que en ingeniería del software es un patrón diseñado para limitar la creación de objetos pertenecientes a una clase.
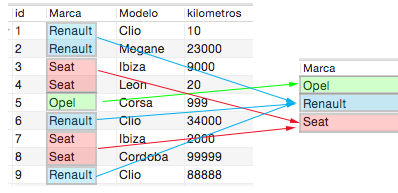
La sentencia "Group By" tiene como finalidad la de agrupar valores idénticos de una tabla.

Pandas es una librería de python para el análisis de datos que proporciona unas estructuras de datos flexibles y que permiten trabajar de forma muy eficiente
En este tutorial vamos a mostrar algunas de las operaciones y funcionalidades que nos aporta la librería de Pandas para trabajar con DataFrame's.
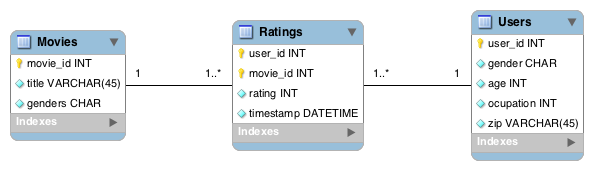
Aprende a usar pivot_table de Pandas para agrupar y calcular datos como en una hoja de cálculo, con el dataset MovieLens de 100K votos.