Qué es un modelo (y por qué una recta ya cuenta como uno)
Qué es un modelo, entrenar y predecir, con una recta que ajustas arrastrando puntos. Y por qué un modelo no entiende sus datos. Curso de IA, 0.4.
Curso de IA › Nivel 0 — Cómo ve el mundo una máquina parte 4 de 4
«Modelo», «entrenar» y «predecir» son palabras que salen constantemente al hablar de IA, y las tres caben en una recta: el modelo es la recta, entrenar es colocarla entre los puntos y predecir es leer su altura en un punto nuevo.
Toca esto primero
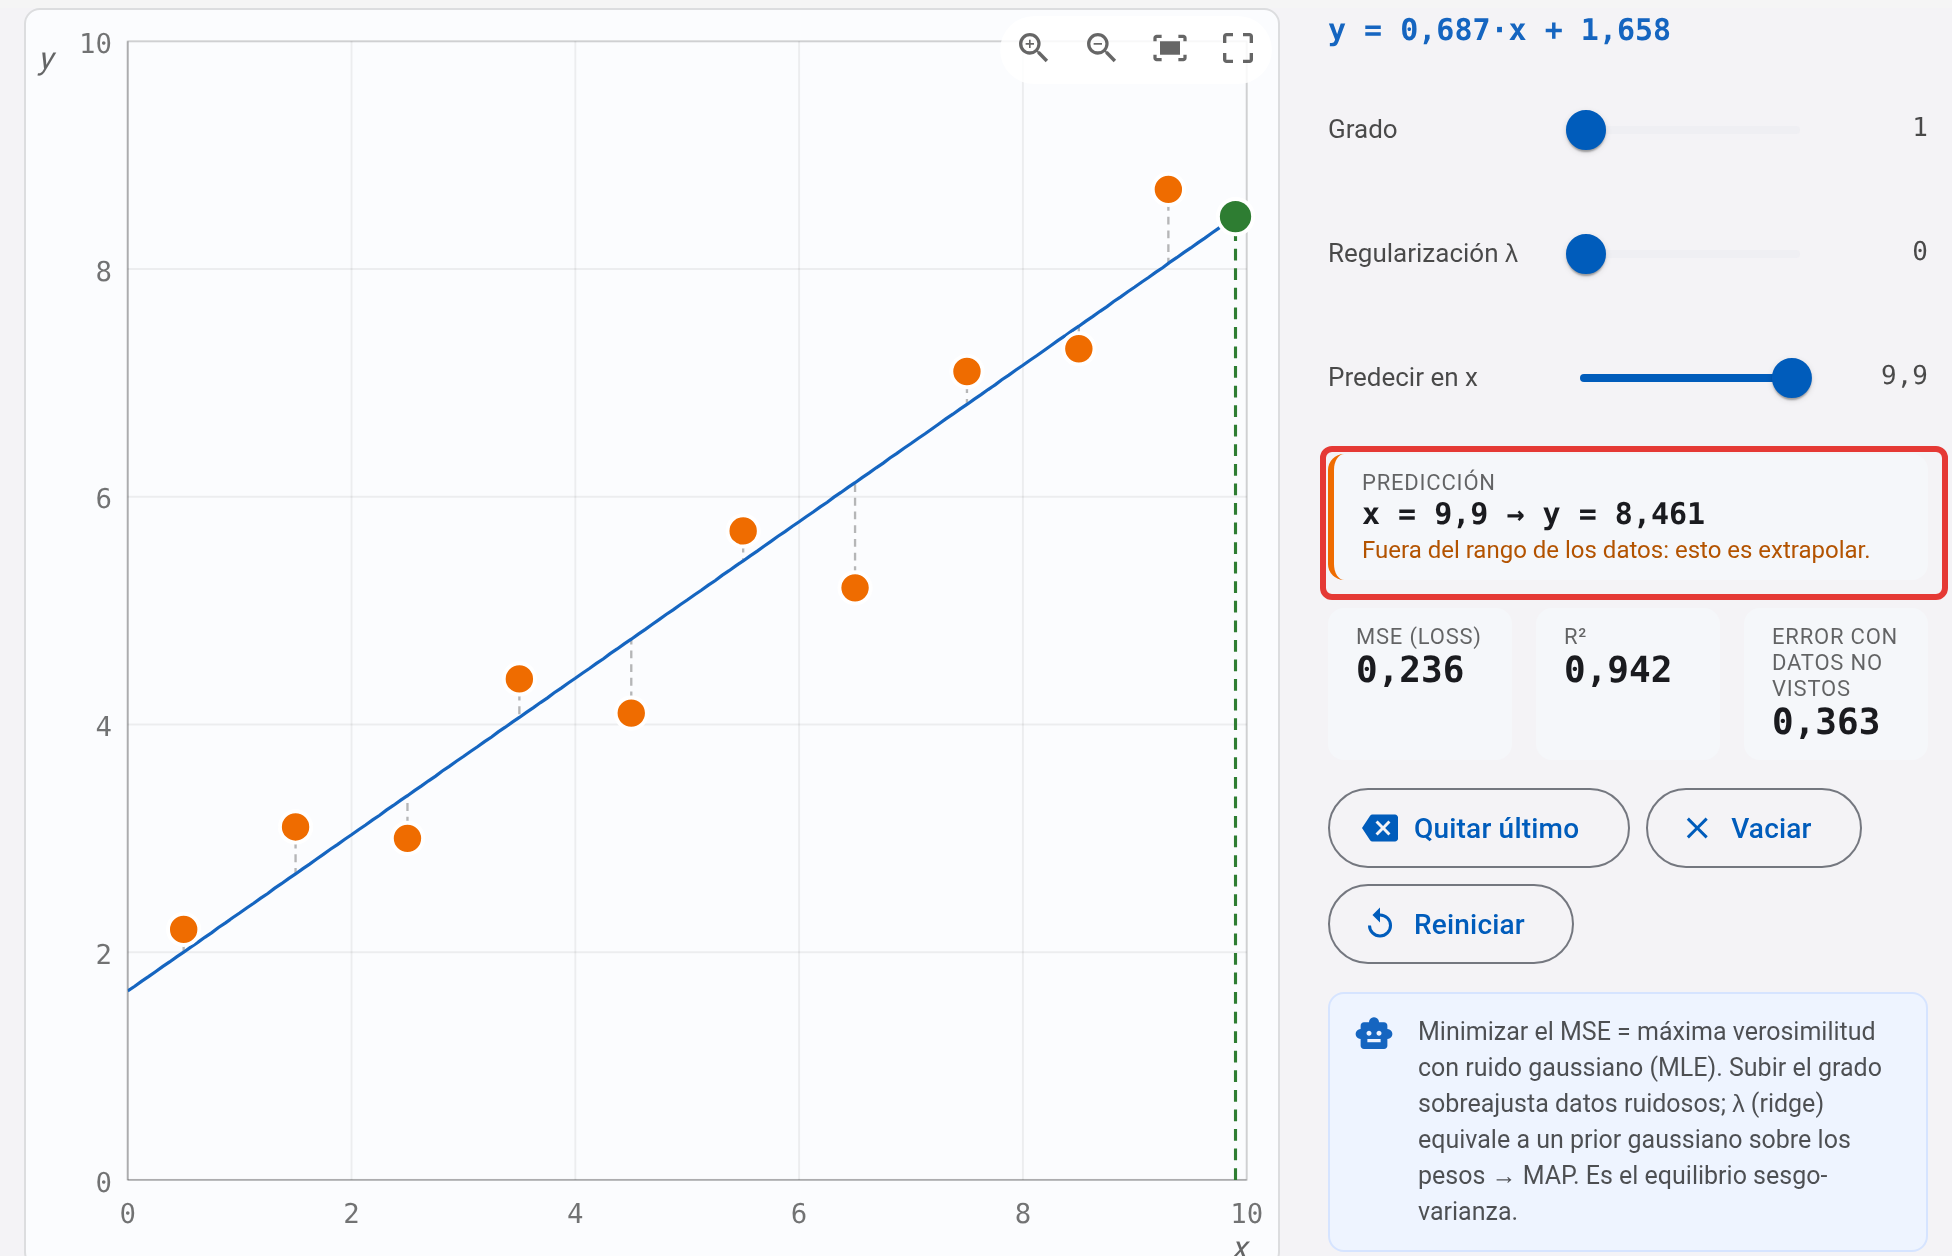
Abre la herramienta Regresión y MLE. Vas a ver diez puntos y una recta que pasa entre ellos. Las líneas grises verticales que unen cada punto con la recta son los residuos: lo que se equivoca la recta en ese punto. A la derecha, MSE (loss) vale 0,236. MSE es el error cuadrático medio (mean squared error), y loss («pérdida») es el nombre que se da al error que se quiere hacer pequeño: cada error se eleva al cuadrado, se suman los diez y se divide entre diez. (Más abajo tienes la cuenta hecha punto a punto, por si quieres repetirla en papel.)
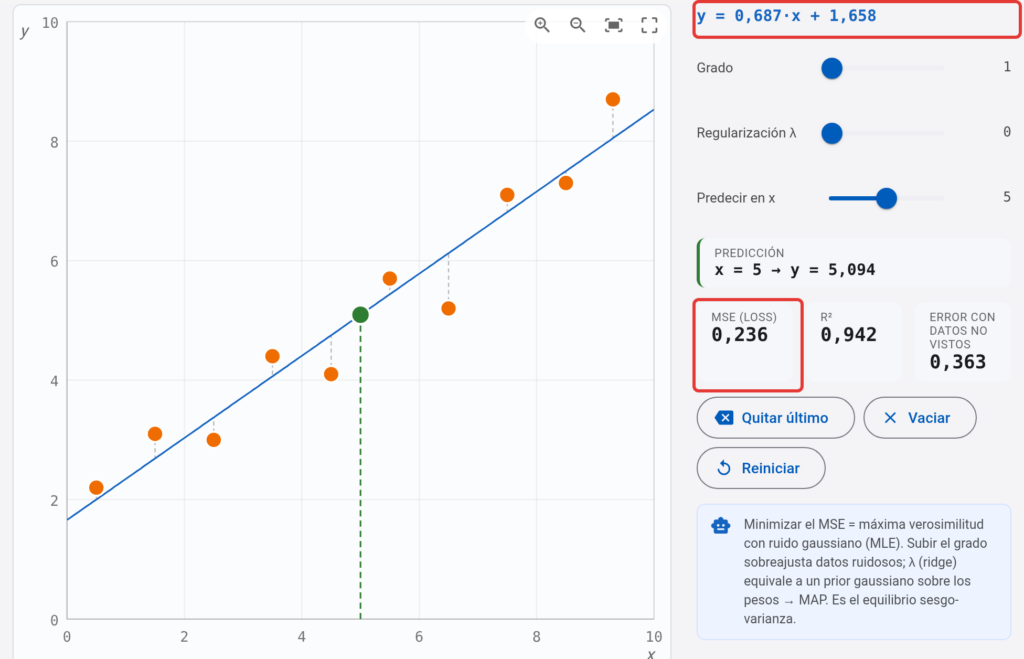
Coge el quinto punto empezando por la izquierda y arrástralo hacia arriba. La recta se inclina un poco hacia él y el MSE sube: cuanto más lo alejas, más. Tú no has tocado la recta: se ha vuelto a calcular sola para que el error total sea el menor posible con los puntos nuevos. Mira también la línea de arriba a la derecha, y = 0,687·x + 1,658: mientras arrastras, esos dos números cambian.
Ahora pulsa Vaciar y haz clic en cinco sitios del gráfico para poner tus propios puntos. Con cada clic, la recta se recoloca. Fíjate en los tres primeros. Con un punto, el MSE es 0, pero por un punto pasan infinitas rectas y todas aciertan; la tool se queda con la horizontal. Con dos, la recta pasa exactamente por los dos y el MSE sigue en 0. A partir del tercero, si no están alineados, ninguna recta pasa por todos y el MSE deja de ser 0. Una recta tiene dos números para ajustar: con dos puntos siempre acierta, aunque no haya aprendido nada.
Con tres o cuatro puntos puede salir un aviso rojo de sobreajuste. La tool hace una prueba: quita un punto, ajusta la recta con los demás y mira cuánto falla con el que ha quitado, y lo repite con cada punto. Con tan pocos, la recta se pega a los que tiene y falla mucho con el que no ha visto. Lo que quita el aviso es poner más puntos: con cinco suele desaparecer. El sobreajuste lo verás con calma más adelante, en Ajustar una curva.
Qué acaba de pasar
Acabas de hacer las tres cosas.
Los datos son los puntos. Cada uno es una pareja de números: dónde está en horizontal (x) y en vertical (y). Podrían ser las horas de estudio y la nota de un examen, los metros cuadrados y el precio de un piso, o cualquier cosa que se mida en dos números.
El modelo es la recta. Una recta queda fijada por solo dos números: cuánto se inclina y a qué altura corta el eje vertical. La tool la escribe arriba a la derecha; con los diez puntos de partida es y = 0,687·x + 1,658. Esos dos números (0,687 y 1,658) son el modelo: todo lo que ha aprendido de los diez puntos cabe ahí.
Entrenar es buscar esos dos números. No cualquier recta vale: se busca la que hace más pequeña la media de los errores al cuadrado, el MSE que ves en pantalla. Se elevan al cuadrado para que un error por arriba y otro por abajo no se anulen entre sí, y para que un error grande pese mucho más que uno pequeño. Por eso el método se llama mínimos cuadrados, y no es nuevo: Adrien-Marie Legendre lo publicó en 1805, y en 1809 Carl Friedrich Gauss aseguró que él ya lo usaba desde 1795 (Least squares, en la Wikipedia en inglés).
Consejo
Para hacerlo a mano (puedes saltarte este cuadro; el resto del artículo no lo necesita)
Con los diez puntos de partida de la tool, la recta y su error salen en tres pasos. Σ significa «suma de todas las filas», x̄ es la media de las x e ȳ la media de las y.
1. Las medias. Suma las diez x y divide entre 10: x̄ = 4,98. Igual con las y: ȳ = 5,08.
2. La pendiente (b) y el corte (a). Las fórmulas de mínimos cuadrados para una recta son:
b = Σ (x − x̄)·(y − ȳ) / Σ (x − x̄)² y a = ȳ − b·x̄
(Salen de buscar la recta con la menor suma de errores al cuadrado; para usarlas no hace falta demostrarlas.) La tabla lleva la cuenta punto a punto:
| x | y | x − x̄ | y − ȳ | (x − x̄)·(y − ȳ) | (x − x̄)² |
|---|---|---|---|---|---|
| 0,5 | 2,2 | −4,48 | −2,88 | 12,9024 | 20,0704 |
| 1,5 | 3,1 | −3,48 | −1,98 | 6,8904 | 12,1104 |
| 2,5 | 3,0 | −2,48 | −2,08 | 5,1584 | 6,1504 |
| 3,5 | 4,4 | −1,48 | −0,68 | 1,0064 | 2,1904 |
| 4,5 | 4,1 | −0,48 | −0,98 | 0,4704 | 0,2304 |
| 5,5 | 5,7 | 0,52 | 0,62 | 0,3224 | 0,2704 |
| 6,5 | 5,2 | 1,52 | 0,12 | 0,1824 | 2,3104 |
| 7,5 | 7,1 | 2,52 | 2,02 | 5,0904 | 6,3504 |
| 8,5 | 7,3 | 3,52 | 2,22 | 7,8144 | 12,3904 |
| 9,3 | 8,7 | 4,32 | 3,62 | 15,6384 | 18,6624 |
| Suma | 55,4760 | 80,7360 |
b = 55,476 / 80,736 = 0,68713 y a = 5,08 − 0,68713 × 4,98 = 1,6581. La tool los escribe redondeados: y = 0,687·x + 1,658.
3. El error de cada punto y el MSE. Para cada punto, la predicción es a + b·x; el error, lo que hay entre el punto y la recta (y − predicción); y se eleva al cuadrado:
| x | y | predicción a + b·x | error = y − predicción | error² |
|---|---|---|---|---|
| 0,5 | 2,2 | 2,002 | 0,198 | 0,0393 |
| 1,5 | 3,1 | 2,689 | 0,411 | 0,1691 |
| 2,5 | 3,0 | 3,376 | −0,376 | 0,1413 |
| 3,5 | 4,4 | 4,063 | 0,337 | 0,1135 |
| 4,5 | 4,1 | 4,750 | −0,650 | 0,4227 |
| 5,5 | 5,7 | 5,437 | 0,263 | 0,0690 |
| 6,5 | 5,2 | 6,124 | −0,924 | 0,8546 |
| 7,5 | 7,1 | 6,812 | 0,288 | 0,0832 |
| 8,5 | 7,3 | 7,499 | −0,199 | 0,0395 |
| 9,3 | 8,7 | 8,048 | 0,652 | 0,4246 |
| Suma | 2,3569 |
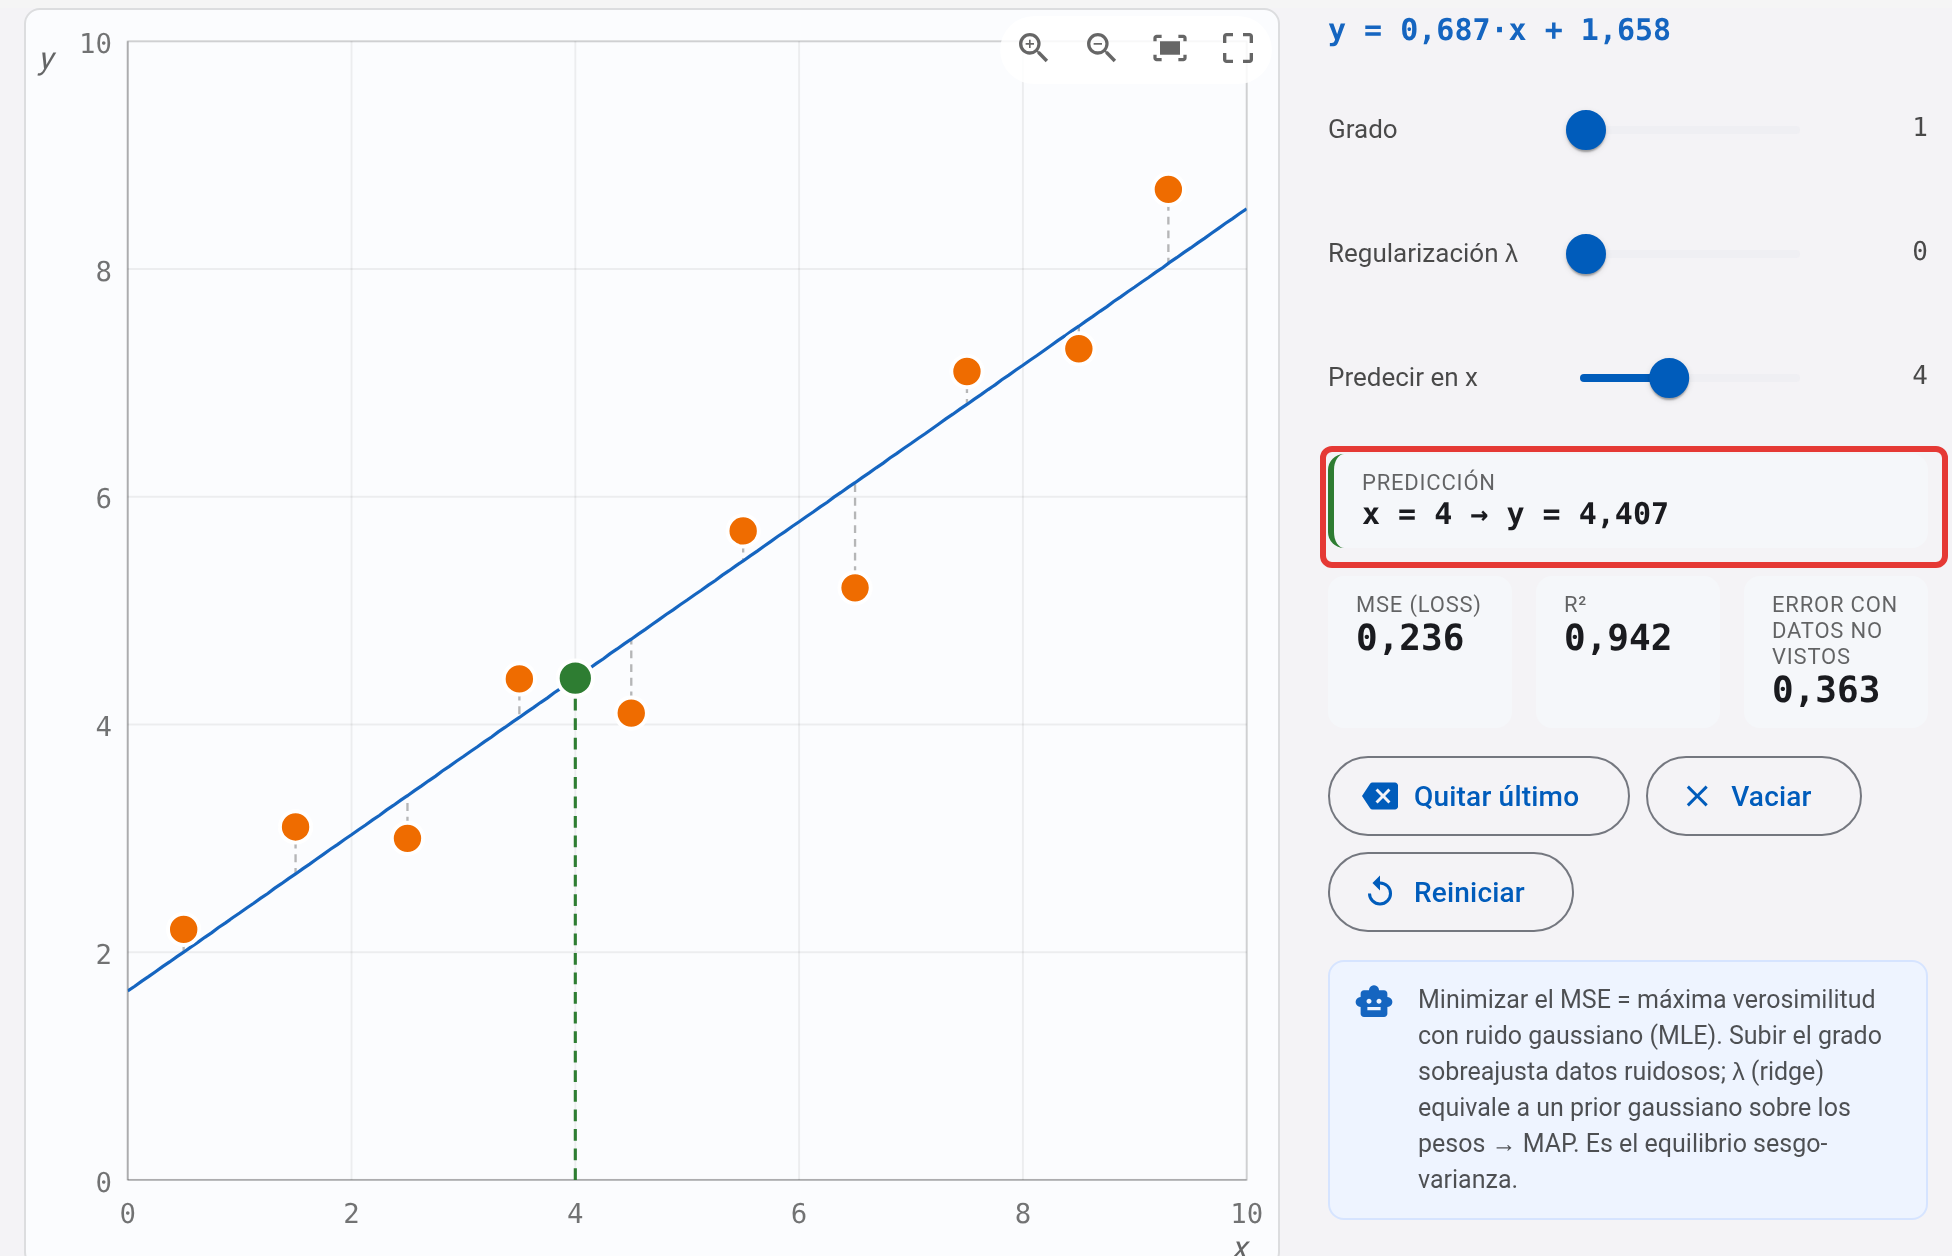
La media de esos diez errores al cuadrado es 2,3569 / 10 = 0,236: el MSE que enseña la tool. (Según cuántos decimales redondees por el camino, puede salirte algún milésimo distinto.) Con la misma recta, la predicción en x = 4 es 1,6581 + 0,68713 × 4 = 4,407.
Para una recta, esos dos números se pueden calcular de golpe con una fórmula, y es lo que hace la tool cada vez que mueves un punto. Los modelos grandes tienen tantos números que no hay fórmula que los saque de una vez, y se ajustan a pasitos, corrigiendo un poco en cada vuelta (esa forma de entrenar es la de Cómo aprende una máquina). La idea de fondo es la misma: buscar los números que hacen el error más pequeño.
Predecir es usar la recta con un x que no estaba en los datos. Abre la misma herramienta con la predicción en x = 4: el punto verde sobre la recta y la lectura x = 4 → y = 4,407. No hay nada más detrás: una predicción es la altura de la recta en ese punto.
El nombre de todo esto, regresión, también tiene historia. Viene de un estudio de Francis Galton de 1886 sobre alturas. Galton comparó la altura de cada hijo con la media de la de sus dos padres, y vio que los hijos se alejaban de la altura media de la población menos que sus padres: si la media de los dos padres estaba, por ejemplo, 6 cm por encima de la media, los hijos solían quedar también por encima, pero solo unos 4 cm: más cerca de la media. Con los padres bajos pasaba lo mismo, por debajo. Calculó que los hijos se quedaban en torno a dos tercios de la distancia de sus padres a la media: «regresaban» hacia ella (Regression toward the mean, en la Wikipedia en inglés). El nombre se quedó para el método aunque no tenga nada que ver con volver atrás.
El error típico
Podrías pensar que un modelo entiende los datos. El de este artículo es una recta: no sabe qué son los puntos, solo dónde están. Si los puntos fueran horas de estudio y notas, la recta seguiría subiendo sin límite, y con 50 horas «predeciría» una nota de 36 sobre 10. No es un fallo del cálculo: la recta hace exactamente lo que se le pidió; lo que no sabe es cuándo ha dejado de tener sentido. La tool sí te lo señala: pide una predicción en x = 9,9, más allá del último punto, y debajo aparece «Fuera del rango de los datos: esto es extrapolar». Ese aviso no sale de la recta: lo ha puesto quien hizo la tool. En los modelos grandes pasa lo mismo, con muchos más números.
Qué cambia en tu trabajo
Cuando una herramienta de IA te da una cifra o una recomendación, está haciendo lo mismo que la recta: aplicar lo que aprendió de ejemplos. No sabe si tu caso se parece a esos ejemplos. Si le preguntas por algo muy distinto de lo habitual (un cliente atípico, un producto nuevo, un año raro), la respuesta sale con la misma seguridad, aunque ya no signifique nada. Antes de fiarte de la respuesta, pregúntate si tu caso se parece a aquello con lo que aprendió.
Pruébalo tú mismo
En Regresión y MLE, pulsa Reiniciar para volver a los diez puntos de partida. Sube unos centímetros el primer punto por la izquierda y mira cuánto cambia la inclinación de la recta. Devuélvelo a su sitio con Reiniciar y haz lo mismo con el quinto, que está hacia el centro. ¿Cuál mueve más la recta? ¿Por qué crees que un punto de una punta pesa más que uno del medio?
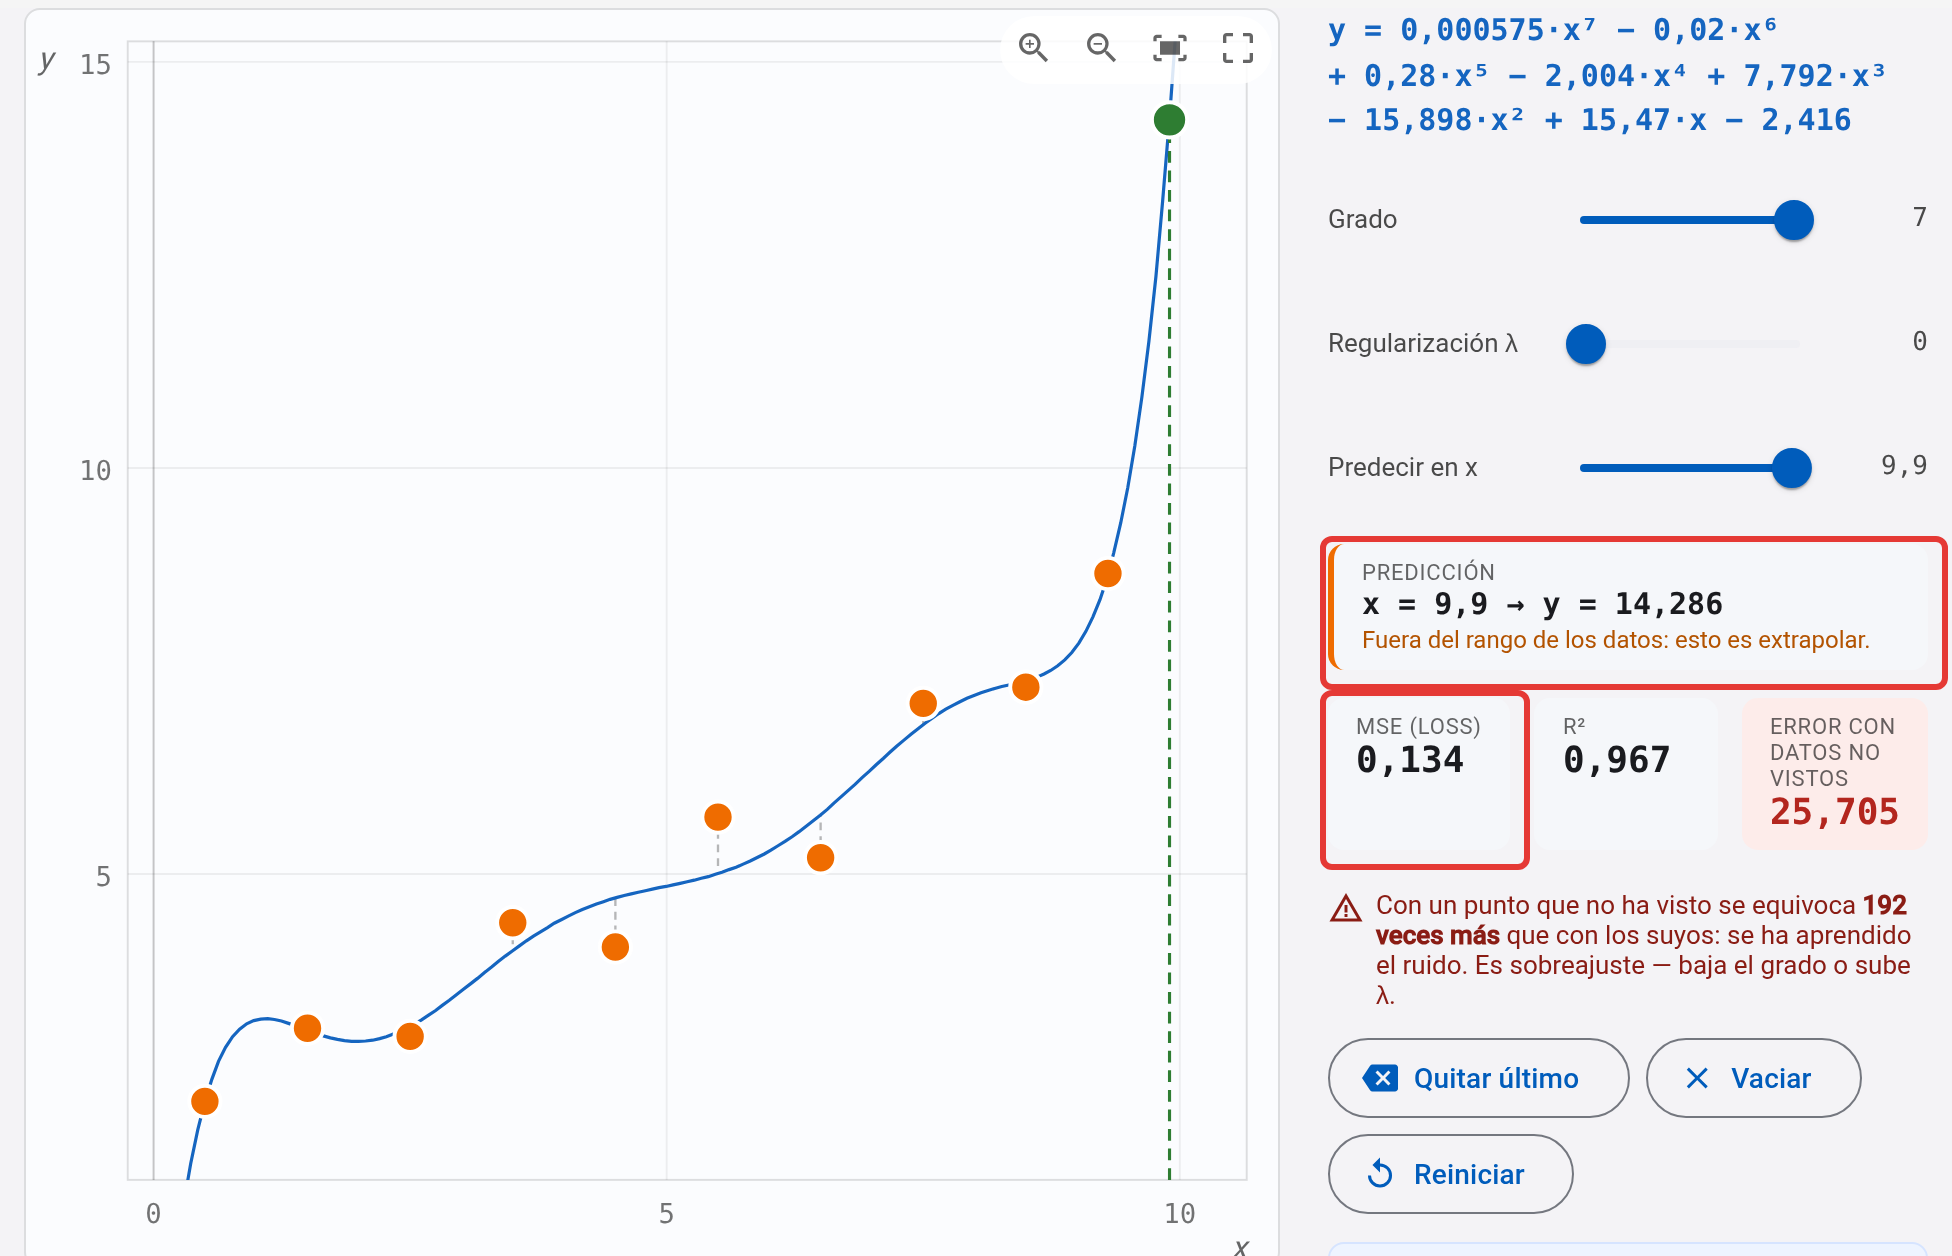
Y para el siguiente paso de la serie: abre la misma herramienta con grado 7. Ya no es una recta: la curva se retuerce para acercarse más a los puntos, el MSE baja (de 0,236 a 0,134) y en los bordes sale disparada. Pide ahora la misma predicción en x = 9,9 con esta curva: la recta decía 8,461; la curva dice 14,286. ¿Es un modelo mejor? Guárdate la respuesta (es el tema de Ajustar una curva).
Si quieres más
- En Jarroba, de Ricardo Moya: ¿Qué es el Machine Learning?, con los conceptos de conjunto de entrenamiento, modelo y sobreajuste explicados con gráficas; y el mapa de algoritmos y conceptos del Machine Learning, para ver dónde encaja la regresión en todo lo demás.
- Least squares, en la Wikipedia en inglés: la historia completa del método, incluida la disputa entre Legendre y Gauss.
«Qué es un modelo (y por qué una recta ya cuenta como uno)», de Ramón Invarato en jarroba.com, con licencia Creative Commons Reconocimiento-NoComercial-CompartirIgual 3.0. Obra registrada en Safe Creative.
Te puede interesar
Cuando un bit se corrompe, y cómo arreglarlo sin saber cuál es
Cómo un ordenador encuentra y arregla un bit estropeado sin saber cuál es: el código de Hamming, sus límites y SECDED. Curso de IA, 0.3.
Una imagen es una tabla de números
Una foto es una tabla de números: tres por píxel, rojo, verde y azul. Lo ves en una manzana y por qué su rojo son miles de números. Curso de IA, 0.2.
Deja un comentario