Todo es un número (sí, hasta tu nombre)
Para una máquina todo es un número: una letra, un emoji, tu nombre. Lo ves en binario y descubres por qué un emoji son cinco caracteres. Curso de IA, 0.1.
Curso de IA › Nivel 0 — Cómo ve el mundo una máquina parte 1 de 4
Antes de hablar de modelos, de redes o de nada que suene a inteligencia artificial, hace falta resolver una pregunta más aburrida: ¿qué ve un ordenador cuando lee una letra? La respuesta corta es «un número». La respuesta completa (un emoji puede ser varios números pegados) se puede comprobar en 30 segundos sin escribir una línea de código.
Toca esto primero
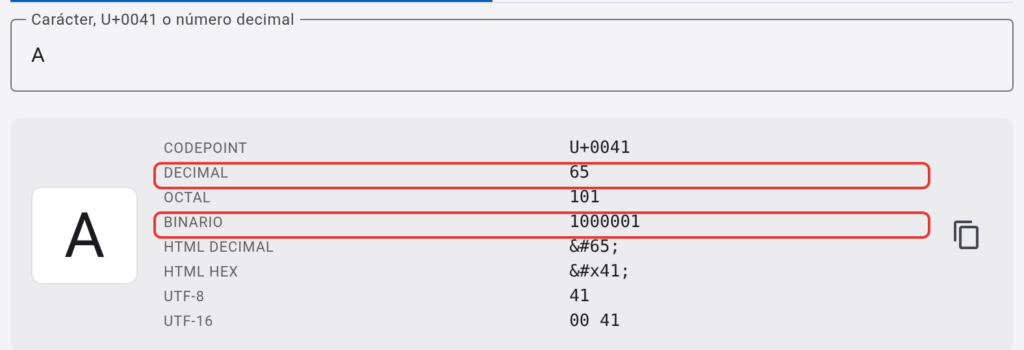
Abre jarroba.com/tools/es/unicode?q=A. Va a cargar el buscador de caracteres con la letra A ya puesta. Verás varias filas de datos, y entre ellas dos que interesan ahora: DECIMAL 65 y BINARIO 1000001. Para el ordenador, la A es el número 65, y 65 en binario se escribe 1000001.
Ahora, en el mismo buscador, borra la A y pega esto: 🚀. Un solo resultado, con un código distinto (U+1F680). Después borra el cohete y pega esto: 👨👩👧. Mira cuántas filas salen esta vez.
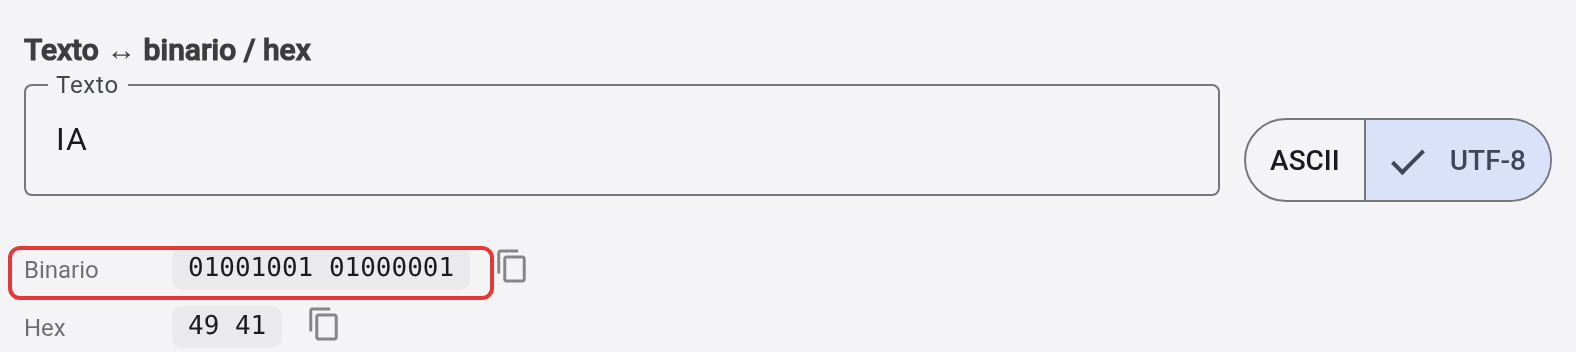
Por último, abre jarroba.com/tools/es/baseconverter?tab=codes&text=IA. Vas a ver la palabra «IA» ya convertida a binario y a hexadecimal, letra por letra. Cambia el texto por tu propio nombre y mira crecer la fila de binario.
Qué acaba de pasar
Para un ordenador no existen letras, ni emojis, ni colores: solo hay números, y todo lo demás es una forma de dibujar esos números en tu pantalla. La letra A es el número 65 porque alguien tuvo que decidir un orden, y ese orden se publicó en 1963 en una tabla llamada ASCII (ASA X3.4-1963, en la Wikipedia en inglés). Décadas después, cuando hizo falta sitio para chino, árabe, emojis y miles de símbolos más, esa tabla se amplió a un estándar mucho más grande: Unicode, que le da a cada carácter posible un número propio, llamado code point (punto de código), escrito como U+ seguido de un valor en hexadecimal. U+0041 es solo 65 escrito en otra base, la misma idea que acabas de ver en el conversor. Unicode reserva sitio para 1 114 112 code points en total, un límite fijo (Unicode Consortium, capítulo 1 del estándar); solo una parte de ese espacio está asignada a caracteres reales, y la lista crece con cada versión nueva del estándar.
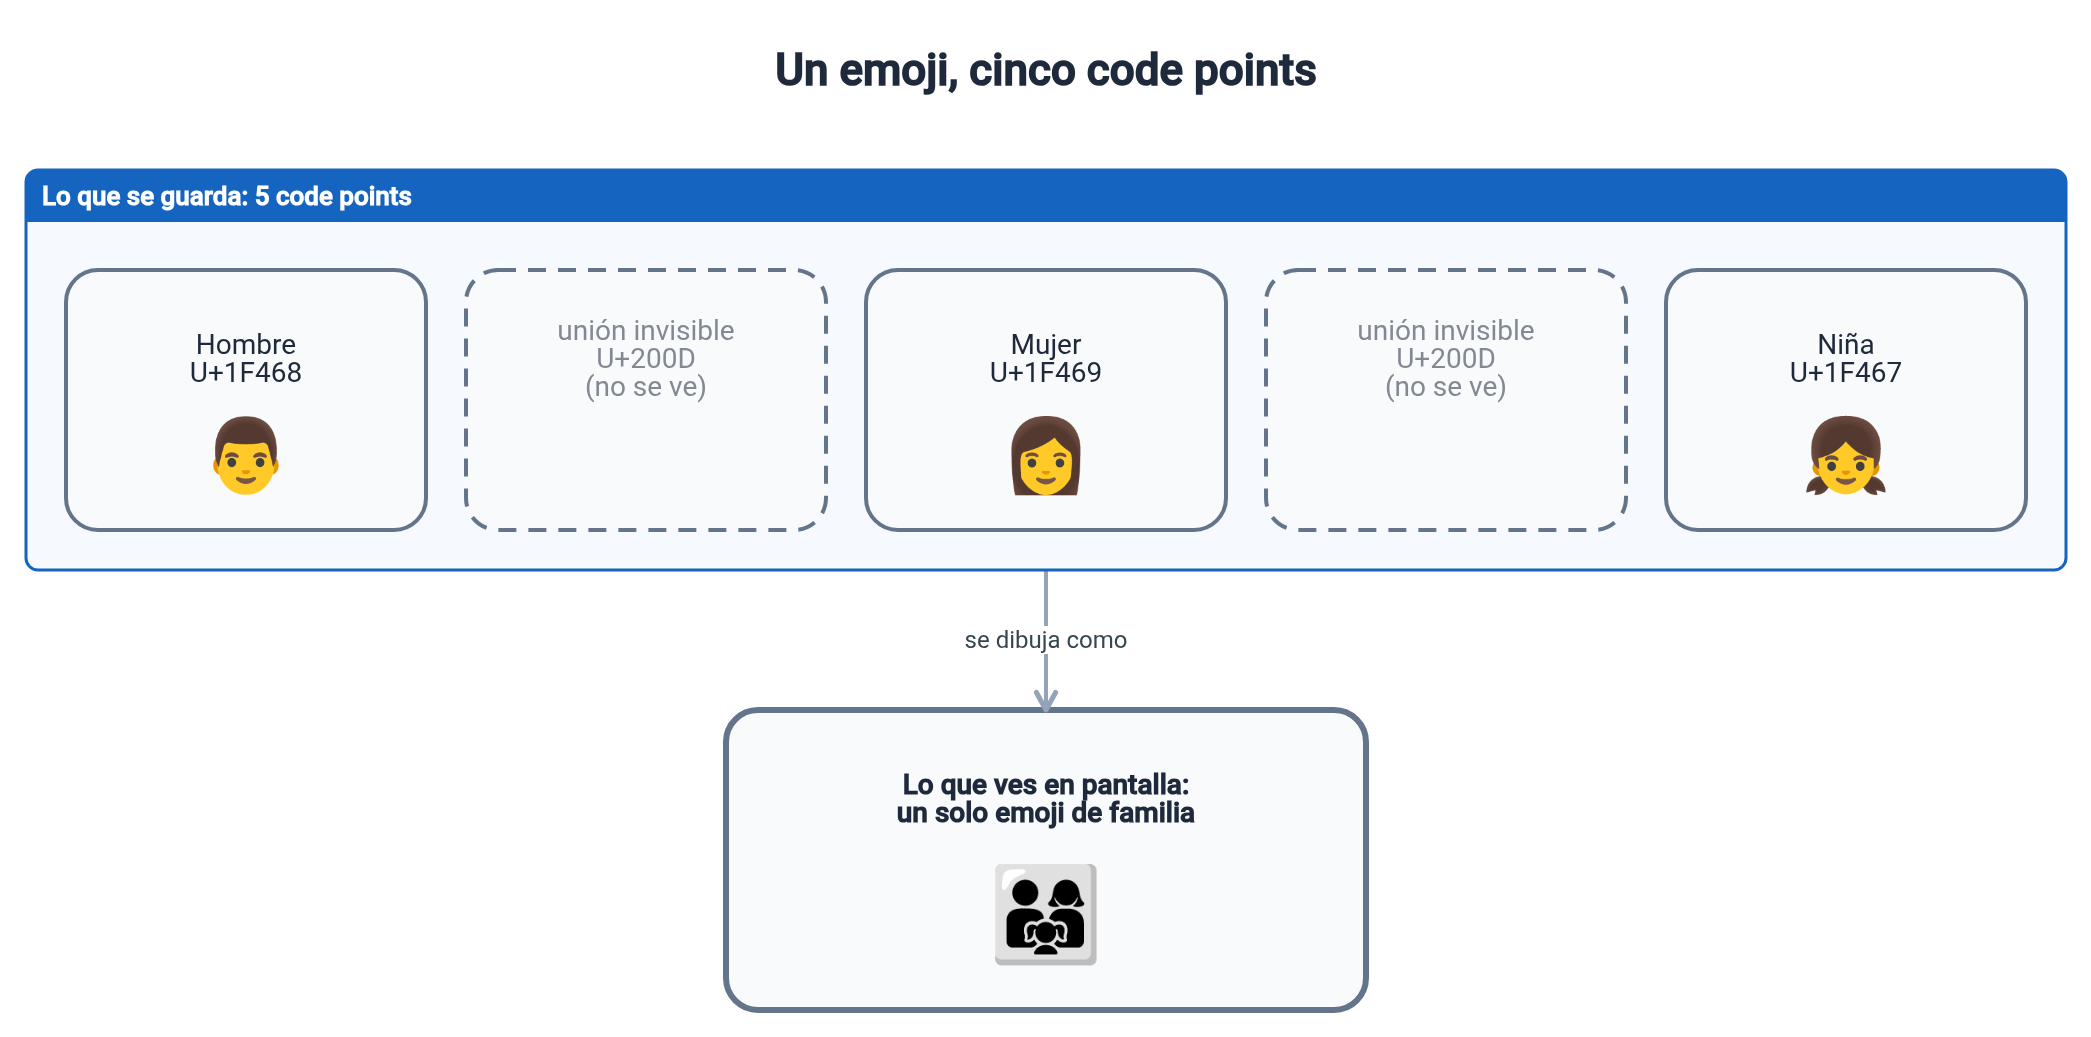
El cohete 🚀 tiene un único code point porque cabe en una casilla: es un carácter como otro cualquiera, solo que dibuja una nave en vez de una letra. La familia 👨👩👧 es distinta. Si has mirado el resultado en el buscador de Unicode / ASCII, habrás visto que no es un carácter, sino cinco unidos para que tu pantalla los dibuje como uno solo: hombre (U+1F468), un carácter de unión invisible (U+200D, el zero-width joiner o «unión de ancho cero»), mujer (U+1F469), otra unión y niña (U+1F467). Unicode no tiene un cajón para cada combinación posible de familia (sería un número imposible de cajones); en vez de eso, coge piezas sueltas y las une con ese carácter que no se ve pero que cuenta.
El error típico
Podrías pensar que un carácter es un byte, y durante años, para texto en inglés, fue verdad: ASCII cabía de sobra en un byte. Se rompe con la primera tilde, el primer carácter chino o el primer emoji. Un byte solo tiene 256 valores posibles (del 0 al 255); en la fila UTF-8 del buscador (UTF-8 es la codificación que usa el 99 % de las webs, según W3Techs) el cohete ocupa cuatro: F0 9F 9A 80. La familia de arriba, con sus cinco code points, ocupa 18 (4 + 3 + 4 + 3 + 4).
Es la misma cuenta que hace un modelo de lenguaje (un LLM, large language model) cuando trocea tu texto en las piezas con las que trabaja de verdad. Eso es tokenizar (dividir en tokens; se cuenta en Cómo se trocea el texto): el precio de usar un modelo se cuenta en tokens, no en letras, y un idioma con más tildes o un texto con más emojis gasta más tokens para el mismo número de letras.
Pruébalo tú mismo
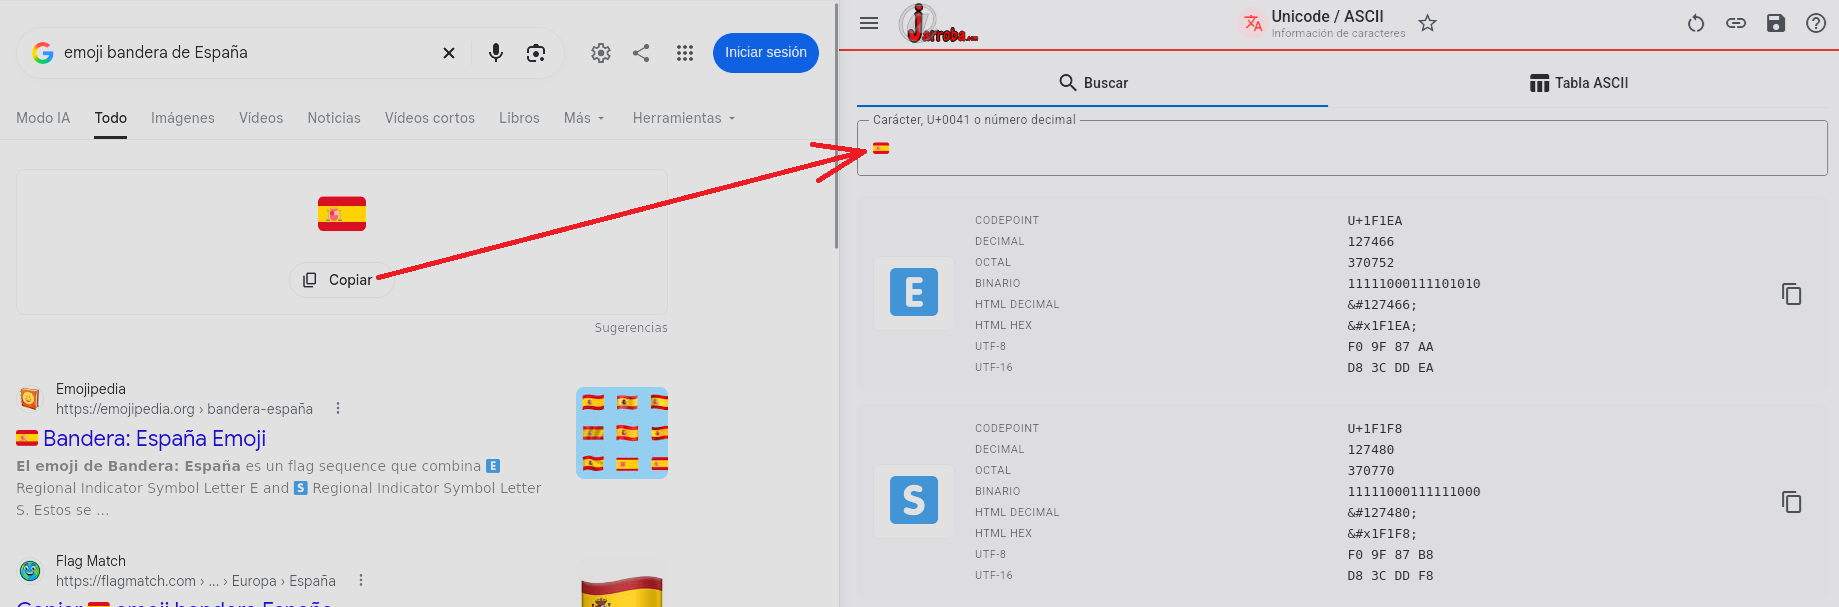
Busca en Google o en Emojipedia el emoji de la bandera de tu país (por ejemplo, «emoji bandera de España»), cópialo desde ahí y pégalo en la herramienta Unicode / ASCII. Antes de mirar el resultado, intenta adivinar cuántos code points va a tener. Después mira los dos que salen (U+1F1xx): ¿ves alguna relación entre esos dos códigos y las dos letras del código de país en inglés (ES, MX, FR…)? No hace falta que lo resuelvas del todo: basta con sospechar que no es casualidad.
Así queda hecho con la de España:
Nota aparte, por si te ha pasado: en Windows muchas banderas no se ven como bandera, sino como dos letras sueltas («ES», «MX»…). Es cosa de Microsoft: su fuente de emojis, Segoe UI Emoji, no incluye banderas de países (Office Watch). Es, de hecho, otro ejemplo de lo que cuenta este artículo: los mismos code points se dibujan distinto según quién los interprete.
Si quieres más
- Unicode, en la Wikipedia en español: su organización y su historia.
- ASCII, en la Wikipedia en inglés: la cronología completa, con las revisiones de 1963, 1967 y 1986.
- Si quieres el tema explicado con más calma y ejemplos de código, Jarroba tiene artículos previos sobre esto, más técnicos y sin las tools de por medio: El sistema de numeración binario, Binario: combinación y conversión, Unidades de medida de la información, Qué es un bit.
«Todo es un número (sí, hasta tu nombre)», de Ramón Invarato en jarroba.com, con licencia Creative Commons Reconocimiento-NoComercial-CompartirIgual 3.0. Obra registrada en Safe Creative.
Te puede interesar
Qué es un modelo (y por qué una recta ya cuenta como uno)
Qué es un modelo, entrenar y predecir, con una recta que ajustas arrastrando puntos. Y por qué un modelo no entiende sus datos. Curso de IA, 0.4.
Cuando un bit se corrompe, y cómo arreglarlo sin saber cuál es
Cómo un ordenador encuentra y arregla un bit estropeado sin saber cuál es: el código de Hamming, sus límites y SECDED. Curso de IA, 0.3.
Deja un comentario